Définition en une phrase
Cálculo que cuantifica el error del modelo respecto al objetivo usado para actualizar sus parámetros durante el entrenamiento.
Définition directe : un critère d’écart
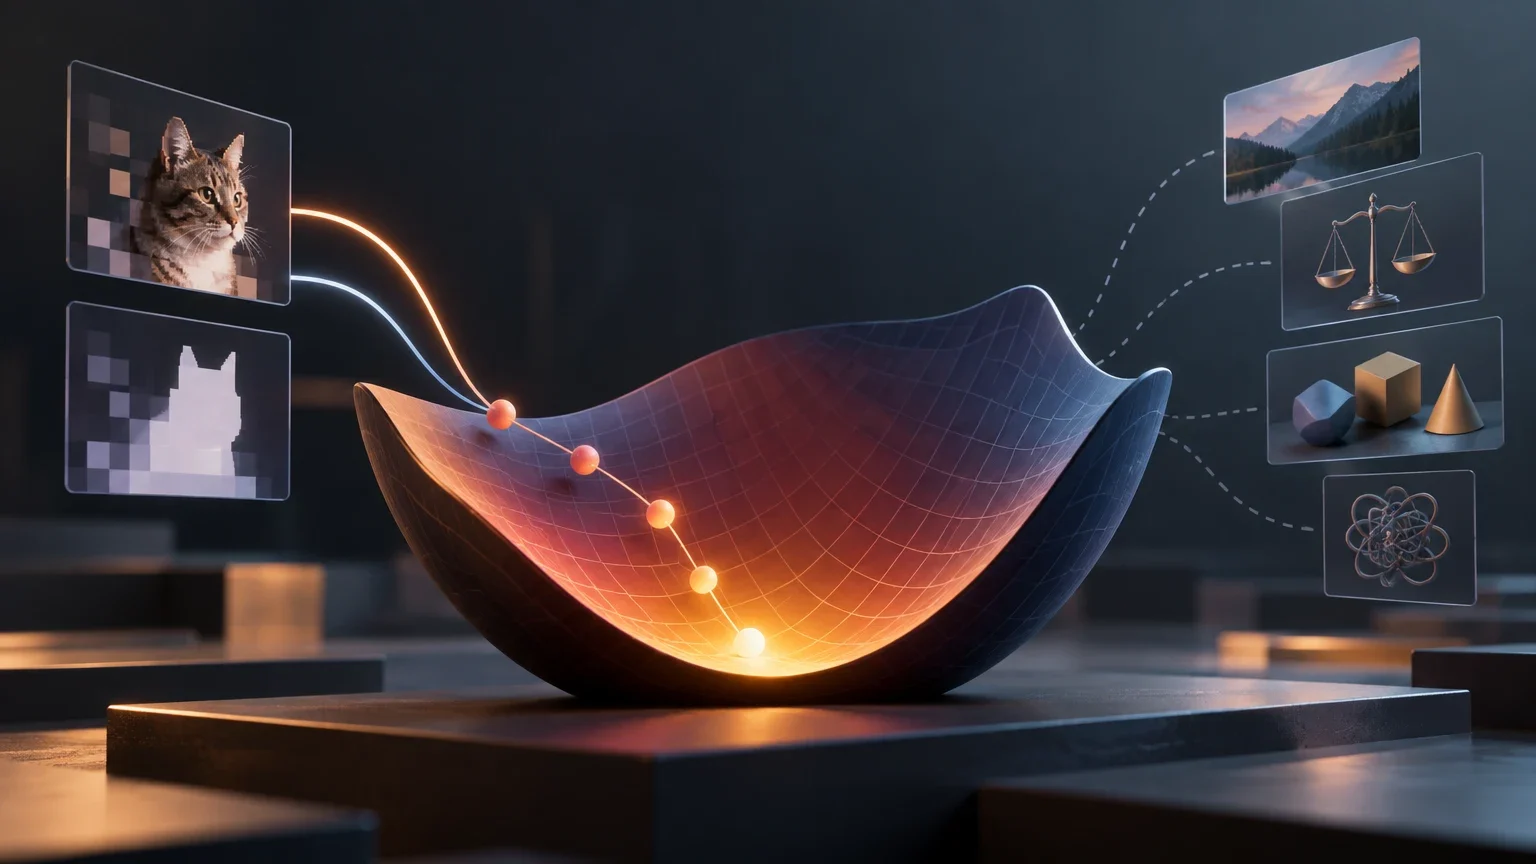
Une fonction de perte est une fonction mathématique qui attribue une valeur à une prédiction en la comparant à une cible ou à un signal de référence, selon un critère défini. Cette valeur représente l’écart que la fonction juge pertinent pour la tâche. Ce n’est pas une mesure universelle de la valeur d’un modèle : elle dépend de ce que le modèle prédit, de la cible utilisée et des erreurs qu’elle pénalise.
Le mot « perte » peut laisser croire que le nombre mesure tout ce qui a échoué. Ce n’est pas le cas. Il décrit le résultat de l’application d’une règle précise à des données déterminées. Deux fonctions peuvent recevoir la même prédiction et la même cible, puis produire des valeurs différentes parce qu’elles pondèrent différemment les types ou les amplitudes d’erreur. Pour interpréter une valeur, il faut donc connaître la tâche et la formulation choisie, et pas seulement constater que le nombre est élevé ou faible.
Dans le langage courant, on dit parfois que la perte correspond à l’« erreur » du modèle. Cette simplification peut être utile, à condition de comprendre qu’il s’agit de l’erreur définie par la fonction, et pas forcément d’un taux d’échec directement compréhensible. Une perte peut être exprimée sur une échelle qui ne se traduit pas immédiatement en « pourcentage de réponses incorrectes » ou en mesure pratique de la qualité.
Le rôle de la perte dans l’entraînement
Le parcours conceptuel commence par une entrée et une prédiction du modèle. La fonction de perte compare cette prédiction à la cible correspondante et produit une valeur. La procédure d’entraînement utilise ce signal pour modifier les paramètres du modèle afin que, selon le critère choisi, les pertes ultérieures puissent diminuer. La perte définit ce qui est mesuré ; la procédure d’optimisation détermine comment les paramètres sont ajustés.
La fonction de perte n’est donc pas, à elle seule, l’algorithme qui met le modèle à jour. Dire qu’un entraînement « minimise la perte » signifie qu’il cherche à réduire la valeur associée à ce critère. Cela ne prouve pas que le modèle soit utile dans une application, que ses réponses soient correctes dans tous les cas ou que le critère représente tous les besoins liés à son utilisation réelle.
Le détail de la mise à jour dépend de la méthode d’entraînement et de l’implémentation. Les méthodes d’optimisation fondées sur les gradients sont courantes, mais la simple mention d’une fonction de perte ne permet pas de déduire quel algorithme a été utilisé. Il ne faut pas non plus confondre le calcul de la perte avec l’étape de mise à jour : ces opérations sont liées, mais elles sont distinctes sur le plan conceptuel.
Parcours élémentaire
- 01Le modèle reçoit une entrée et produit une prédiction.
- 02La fonction de perte compare cette prédiction à la cible définie pour l’entrée concernée.
- 03Le calcul produit une valeur de perte selon le critère retenu.
- 04La procédure d’optimisation utilise le signal d’entraînement pour ajuster les paramètres ; la fonction de perte ne les met pas à jour à elle seule.
- 05Le processus est répété, puis la perte et d’autres mesures pertinentes sont examinées.
Perte d’un exemple et perte agrégée
Une fonction peut produire une valeur pour un exemple individuel. Or, l’entraînement porte souvent sur plusieurs exemples : il faut alors une règle pour réunir leurs valeurs en une quantité agrégée. On peut, par exemple, calculer une moyenne ou appliquer une autre réduction définie par l’implémentation. Il ne faut pas supposer que tous les systèmes agrègent les valeurs de la même façon.
L’agrégation est importante, car elle résume un ensemble, mais elle peut masquer des différences entre les cas. Une moyenne plus faible ne permet pas, à elle seule, de savoir si l’amélioration est homogène ou si certains exemples conservent des pertes élevées. Pour interpréter une courbe, il est également utile de savoir quelles données ont servi au calcul : données d’entraînement, de validation ou autre ensemble, et si leur composition ou leur traitement a changé.
Ainsi, lorsque l’on affirme que « la perte a diminué », plusieurs questions restent en suspens : s’agit-il de la perte par exemple ou de la perte agrégée ? Quelle réduction a été appliquée ? Sur quelle partition de données ? Entre quels moments de l’entraînement ? Sans ces précisions, la tendance peut être informative, mais elle ne décrit pas complètement les performances.
Points à vérifier pour lire une valeur ou une courbe
| Question | Pourquoi est-ce important ? |
|---|---|
| Quelle fonction a été calculée ? | Elle définit les écarts pris en compte et la manière dont ils sont évalués. |
| Quels exemples ont été inclus ? | La valeur dépend des données sur lesquelles elle est calculée. |
| Comment les valeurs ont-elles été agrégées ? | La réduction détermine la façon dont la perte de plusieurs exemples est résumée. |
| S’agit-il de l’entraînement ou de l’évaluation ? | Une perte calculée sur les données d’entraînement ne décrit pas, à elle seule, le comportement sur d’autres données. |
Exemple concret : régression numérique
Imaginons une tâche de régression qui prédit le délai de livraison d’une commande. Pour une commande donnée, le modèle produit une durée estimée, que l’on compare à la durée cible enregistrée. Une fonction de perte attribue une valeur à l’écart entre les deux. Si la prédiction est éloignée de la cible, la valeur peut traduire un écart plus important, conformément à la règle choisie.
Le choix de cette règle modifie le poids accordé aux différentes erreurs. À titre d’illustration, une formulation peut donner une importance particulièrement marquée aux grandes erreurs, tandis qu’une autre peut réduire leur influence relative. On ne peut pas déduire la fonction utilisée du seul mot « régression » : il faut consulter la définition de la fonction et sa configuration.
Cet exemple montre aussi pourquoi l’expression « minimiser l’erreur » est incomplète. L’entraînement cherche à réduire l’écart formalisé par la fonction, pas nécessairement le retard moyen, le coût opérationnel ou la proportion de livraisons effectuées dans un délai acceptable. Ces questions peuvent nécessiter des métriques d’évaluation supplémentaires.
Exemple concret : classification de texte
Dans une tâche de classification de texte, le modèle reçoit un texte et produit une sortie associée à plusieurs classes possibles, telles que « demande d’information », « réclamation » ou « requête ». L’entraînement dispose de labels cibles pour les exemples. Une fonction de perte compare la sortie du modèle à ces labels selon une règle de classification, puis renvoie une valeur qui peut être utilisée pendant l’entraînement.
Cette valeur ne correspond pas automatiquement au pourcentage de textes classés correctement. Le taux de bonnes réponses répond à une autre question : quelle proportion des prédictions finales correspond aux labels, selon une règle de décision donnée ? Une fonction de perte peut tenir compte d’informations supplémentaires présentes dans la sortie du modèle, au-delà du simple succès ou échec de la classe sélectionnée. Deux modèles affichant le même taux de bonnes réponses peuvent donc avoir des pertes différentes, selon leurs sorties et la fonction employée.
Pour interpréter le résultat, il faut vérifier quels labels ont été utilisés, quelle fonction a été choisie et sur quels textes le calcul a été effectué. Il faut également garder à l’esprit qu’une perte d’entraînement plus faible ne garantit pas que le classificateur fonctionnera aussi bien sur de nouveaux textes, sur une autre distribution de sujets ou pour des catégories dont le coût d’erreur diffère.
Exemple concret : détection d’objets
Dans une tâche de détection d’objets, le modèle doit produire des informations sur les objets présents dans une image. À un niveau conceptuel, on peut distinguer les questions portant sur l’emplacement d’un objet et celles portant sur sa classe. Une fonction de perte pour cette tâche peut refléter des écarts concernant plusieurs aspects de la prédiction ; la manière de combiner ces composantes dépend du modèle et de son implémentation.
Cet exemple évite une simplification : une tâche complexe ne se résume pas toujours à une erreur élémentaire unique. Il ne serait toutefois pas rigoureux d’attribuer à tous les détecteurs une formule, une liste fixe de composantes ou une pondération universelle. Pour décrire une fonction de détection précise, il faudrait consulter la documentation technique de l’implémentation concernée, notamment pour savoir quels termes elle calcule et comment elle les agrège.
La perte ne remplace pas automatiquement les mesures utilisées pour évaluer les détections. Si un rapport donne une valeur de perte, il faut déterminer quel critère elle représente ; s’il donne une métrique d’évaluation, sa définition doit être consultée séparément. Il est utile de comparer ces deux types d’informations, mais cela ne signifie pas que leurs valeurs se trouvent sur la même échelle.
Notions voisines : perte, métrique, coût et optimiseur
Une métrique d’évaluation résume un aspect des performances à l’aide d’une règle de mesure. Elle peut aider à répondre à des questions telles que le nombre de prédictions correctes ou la qualité d’un résultat selon une définition précise. Une perte, en revanche, est le critère qui attribue une valeur aux prédictions et aux cibles pour la tâche spécifiée. Certaines métriques et fonctions de perte peuvent être liées, mais elles ne sont pas synonymes par défaut et ne s’interprètent pas nécessairement de la même manière.
Le terme « erreur » est général et ambigu : il peut désigner l’écart calculé par une fonction formelle, une prédiction incorrecte ou une métrique exprimée dans des unités compréhensibles. Mieux vaut nommer précisément la quantité concernée. L’expression « fonction de coût » est également employée de différentes façons dans les textes techniques, par exemple pour désigner un critère agrégé. Il ne faut pas supposer que tous les auteurs distinguent la perte individuelle du coût agrégé selon la même terminologie.
L’objectif d’entraînement est le critère plus large que l’on cherche à optimiser dans une configuration donnée. La fonction de perte peut faire partie de cet objectif, mais une description complète peut inclure d’autres éléments. L’optimiseur est la procédure qui effectue les mises à jour des paramètres. En résumé : la perte est une mesure définie ; l’objectif est ce que l’on cherche à optimiser ; l’optimiseur est la méthode qui organise les mises à jour ; la métrique est un moyen d’évaluer une propriété.
Distinctions utiles
| Concept | Question à laquelle il aide à répondre | À ne pas confondre avec |
|---|---|---|
| Fonction de perte | Quelle valeur le critère attribue-t-il à la prédiction par rapport à la cible ? | Une description complète de l’utilité du modèle. |
| Métrique d’évaluation | Comment résumer un aspect des performances ? | La perte d’entraînement, sauf si elle est explicitement définie ainsi. |
| Optimiseur | Comment les paramètres sont-ils ajustés pendant l’entraînement ? | La fonction qui calcule la perte. |
| Coût ou objectif agrégé | Quelle quantité globale cherche-t-on à optimiser dans une formulation précise ? | Une terminologie universelle dont le sens serait identique dans toutes les sources. |
Ce qu’une perte faible ne démontre pas
Une perte faible indique que, sur les données considérées et selon la fonction définie, la valeur du critère est basse. Elle ne prouve pas, à elle seule, que le modèle généralise bien à des exemples jamais vus, qu’il est bien calibré, qu’il est utile aux personnes qui l’utilisent ou qu’il traite équitablement différents groupes. Ces propriétés exigent des définitions, des données et des évaluations adaptées.
Les données d’entraînement peuvent aussi différer des données utilisées en pratique. Si le modèle ajuste très bien le critère sur les exemples d’entraînement, mais que son comportement se dégrade sur d’autres données, la perte d’entraînement ne suffit pas à détecter ou à expliquer le problème. Comparer les résultats sur des ensembles appropriés peut apporter des éléments utiles, même si le choix et la représentativité de ces ensembles comptent également.
Une courbe ne parle pas sans contexte. Son interprétation dépend de la fonction, de l’agrégation, des données et du moment où elle est calculée. Une tendance à la baisse peut indiquer que la procédure réduit le critère optimisé, mais elle ne permet pas de conclure sans autre information que toutes les capacités du modèle s’améliorent. Cette distinction est essentielle pour comprendre la généralisation et le surapprentissage.
Repères pratiques pour interpréter une perte
- 01Identifiez la tâche, la fonction exacte et la cible à laquelle la prédiction est comparée.
- 02Déterminez si la valeur concerne un exemple ou une agrégation, et quelle règle d’agrégation a été appliquée.
- 03Vérifiez quelle partition des données a produit la valeur et si elle est comparable à celle utilisée pour la comparaison.
- 04Consultez les métriques adaptées aux conséquences pratiques des erreurs dans cette tâche.
- 05Ne déduisez pas la généralisation, la calibration, l’utilité ou l’absence de biais d’une valeur de perte isolée.
Erreurs fréquentes et notions associées
Une erreur fréquente consiste à dire que le modèle « a appris parce que la perte est tombée à zéro ». La valeur zéro n’a de signification précise que par rapport à une fonction et à des données déterminées ; elle ne prouve pas que le système résout correctement tous les cas pertinents. Une autre erreur consiste à comparer directement des pertes issues de tâches, de fonctions ou de configurations différentes. Sans formulation compatible, les chiffres peuvent ne pas être comparables.
On confond également la fonction de perte avec l’algorithme d’optimisation, ou l’on présente une perte comme s’il s’agissait d’une métrique produit. Pour éviter ces confusions, il est plus clair d’indiquer la fonction utilisée, l’ensemble de données sur lequel elle a été calculée et la métrique qui évalue le résultat opérationnel. Dans une description de l’entraînement, la perte précise le critère ; dans une description des résultats, les mesures d’évaluation doivent être explicitées.
Pour approfondir, cette fiche est liée à l’évaluation, à la généralisation et au surapprentissage : la perte ne constitue qu’un élément de l’analyse de l’entraînement, tandis que ces notions aident à examiner le comportement au-delà de la valeur optimisée. Elle concerne également le réglage fin et l’apprentissage auto-supervisé, où la formulation de l’objectif détermine le signal utilisé. La page du glossaire et la comparaison entre notions apparentées peuvent servir de pistes de consultation, mais chaque terme doit être défini dans son propre contexte.