Uma fonte jornalística noticia uma intimação relacionada a incidentes de cibersegurança envolvendo agentes de IA. O material disponível não permite confirmar o episódio do Hugging Face, o alcance do acesso nem se houve extração de dados ou danos.
Duas publicações descrevem modelos da Microsoft para transcrição em streaming e síntese de voz. A documentação fornecida confirma parte do contexto, mas não verifica de forma independente os números de latência nem o alcance dos 23 idiomas.
O trabalho afirma reduzir a taxa de sucesso de backdoors sem retreinar os parâmetros suspeitos e sem depender, segundo o resumo, de gatilhos conhecidos ou referências limpas. Os detalhes experimentais disponíveis não são suficientes para verificar essas afirmações de forma independente.
Uma análise de 22 benchmarks distingue a fiabilidade da comparação entre sistemas implementados da fiabilidade de atribuir diferenças aos modelos. Os resultados sugerem que mais tarefas não eliminam todas as incertezas.
Guia prático para transformar respostas de um modelo em dados que uma aplicação possa verificar e utilizar. Aprenda a definir um contrato, validar o formato e o significado separadamente, preparar respostas para falhas e testar casos-limite antes da implementação.
Um guia operacional para controlar a inclusão, as alterações e a remoção de documentos num corpus RAG, registar a proveniência dos documentos e confirmar que as atualizações se refletem nas pesquisas.
O Google descreve o Gemini 3.8 Live como um modelo para diálogo em tempo real, mas as fontes disponíveis não permitem confirmar uma tarifa, resultados quantitativos ou todas as condições de acesso. Este guia separa as afirmações do fornecedor daquilo que uma equipe precisa verificar na própria integração.
O Google descreve o Gemini 3.8 Live Extended Thinking como um modelo de áudio para áudio da Live API, recomendado quando é necessário mais raciocínio em segundo plano. A documentação disponível, por si só, não demonstra que isso reduza erros ou melhore a latência: essas questões exigem testes com tarefas e condições controladas.
A ElevenLabs apresenta o v4 Turbo como uma variante de baixa latência e publica uma mediana de inferência próxima de 100 ms. Esse valor não corresponde ao tempo de resposta de um agente completo: faltam detalhes sobre a medição, as condições de acesso, o custo aplicável e evidências específicas de segurança.
As fontes disponíveis apontam para avaliações do fornecedor, uma ficha técnica e um estudo independente sobre agentes de IDE, mas não oferecem detalhes suficientes para tratá-las como uma classificação comum. Este guia separa o que está documentado daquilo que ainda precisa ser verificado.
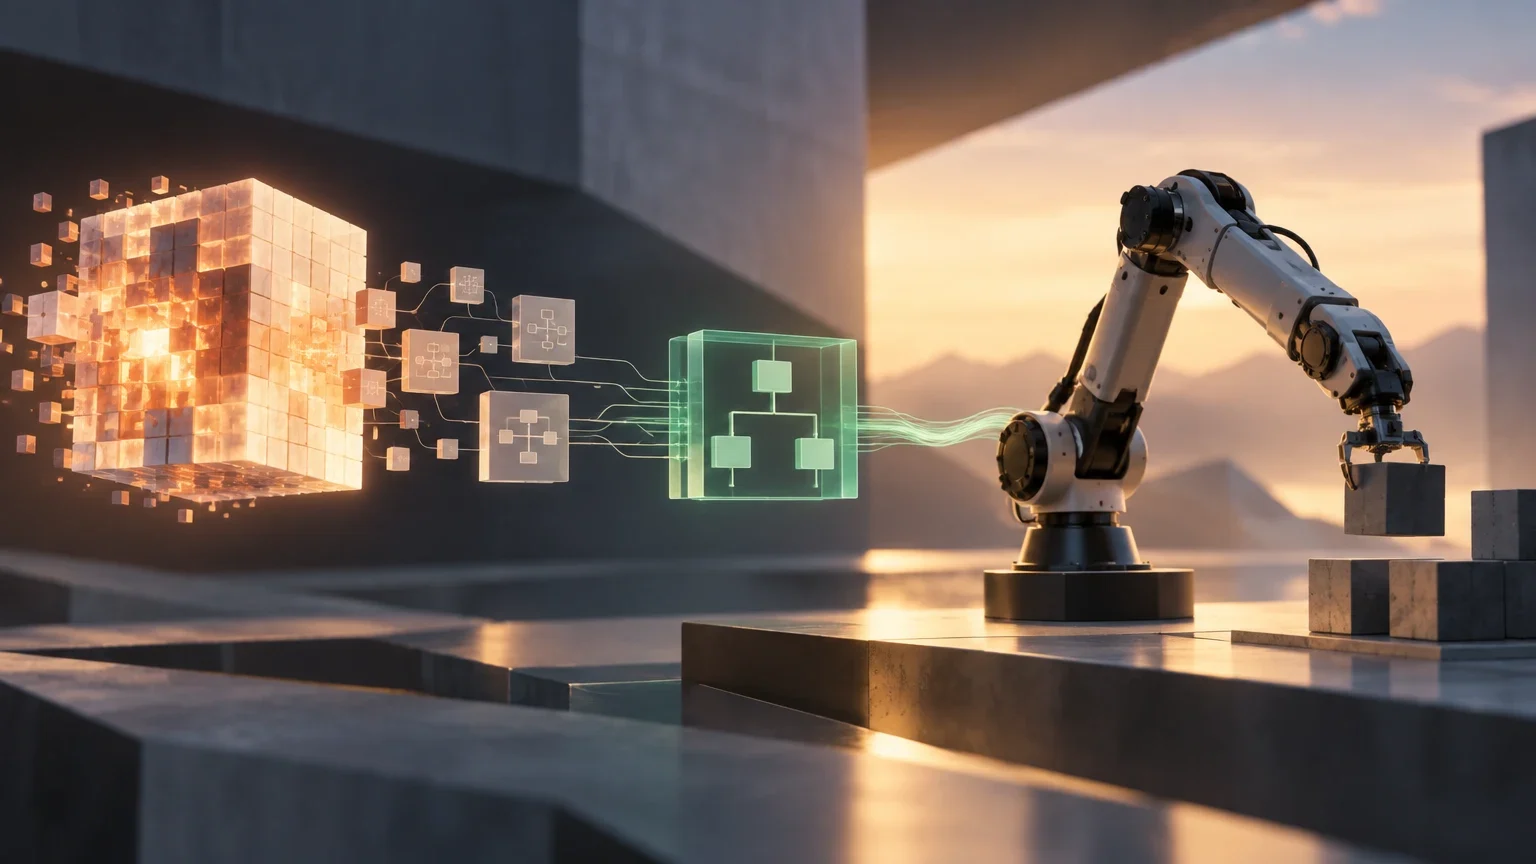
Code to Control separa a geração da estrutura de um controlador do ajuste dos seus parâmetros. O preprint afirma que, depois de aprendido, o controlador pode atuar sem inferência do LLM nem planeamento em cada passo; as evidências disponíveis não bastam para avaliar os números, a reprodutibilidade ou a preparação para robôs reais.
A ElevenLabs descreve o Eleven v4 como seu modelo de síntese de voz mais expressivo e com maior controle. Essa caracterização vem do próprio fabricante: por si só, não quantifica a qualidade nem demonstra que os resultados sejam consistentes. Veja o que as fontes disponíveis permitem afirmar e o que uma equipe ainda precisa verificar.