Una fonte giornalistica riferisce di una citazione legata a incidenti di cybersicurezza che coinvolgono agenti di IA. Le informazioni disponibili non consentono di confermare l’episodio di Hugging Face, la portata dell’accesso né eventuali estrazioni di dati o danni.
Due pubblicazioni descrivono modelli Microsoft per la trascrizione in streaming e la sintesi vocale. La documentazione fornita conferma parte del contesto, ma non verifica in modo indipendente i dati sulla latenza né la portata del supporto a 23 lingue.
Il lavoro afferma di ridurre il tasso di successo delle backdoor senza riaddestrare i parametri sospetti e senza dipendere, secondo il suo abstract, da trigger noti o da riferimenti puliti. I dettagli sperimentali disponibili non bastano per verificare in modo indipendente queste affermazioni.
Un’analisi di 22 benchmark distingue l’affidabilità del confronto tra sistemi distribuiti da quella dell’attribuzione delle differenze ai modelli. I risultati indicano che più attività non eliminano ogni incertezza.
Guida pratica per trasformare le risposte di un modello in dati che un’applicazione possa verificare e utilizzare. Scopri come definire un contratto, validare separatamente formato e significato, gestire gli errori e testare i casi limite prima della distribuzione.
Una guida operativa per gestire aggiunte, modifiche e rimozioni in un corpus RAG, registrare la provenienza dei documenti e verificare che gli aggiornamenti si riflettano nelle ricerche.
Google descrive Gemini 3.8 Live come un modello per il dialogo in tempo reale, ma le fonti disponibili non consentono di confermare una tariffa, risultati quantitativi o condizioni complete di accesso. Questa guida distingue le affermazioni del fornitore dagli aspetti che un team deve verificare nella propria integrazione.
Google descrive Gemini 3.8 Live Extended Thinking come un modello audio-audio per la Live API, consigliato quando serve un maggiore livello di ragionamento in background. La documentazione disponibile, da sola, non dimostra che riduca gli errori o migliori la latenza: per verificarlo servono test con attività e condizioni controllate.
ElevenLabs presenta v4 Turbo come una variante a bassa latenza e dichiara una latenza mediana di inferenza vicina a 100 ms. Questo dato non equivale al tempo di risposta di un agente completo: mancano dettagli sulle modalità di misurazione, sulle condizioni di accesso, sui costi applicabili e su evidenze specifiche in materia di sicurezza.
Le fonti disponibili rimandano a valutazioni del fornitore, a una scheda tecnica e a uno studio indipendente sugli agenti IDE, ma non offrono dettagli sufficienti per trattarle come un’unica classifica. Questa guida distingue ciò che risulta documentato da ciò che deve ancora essere verificato.
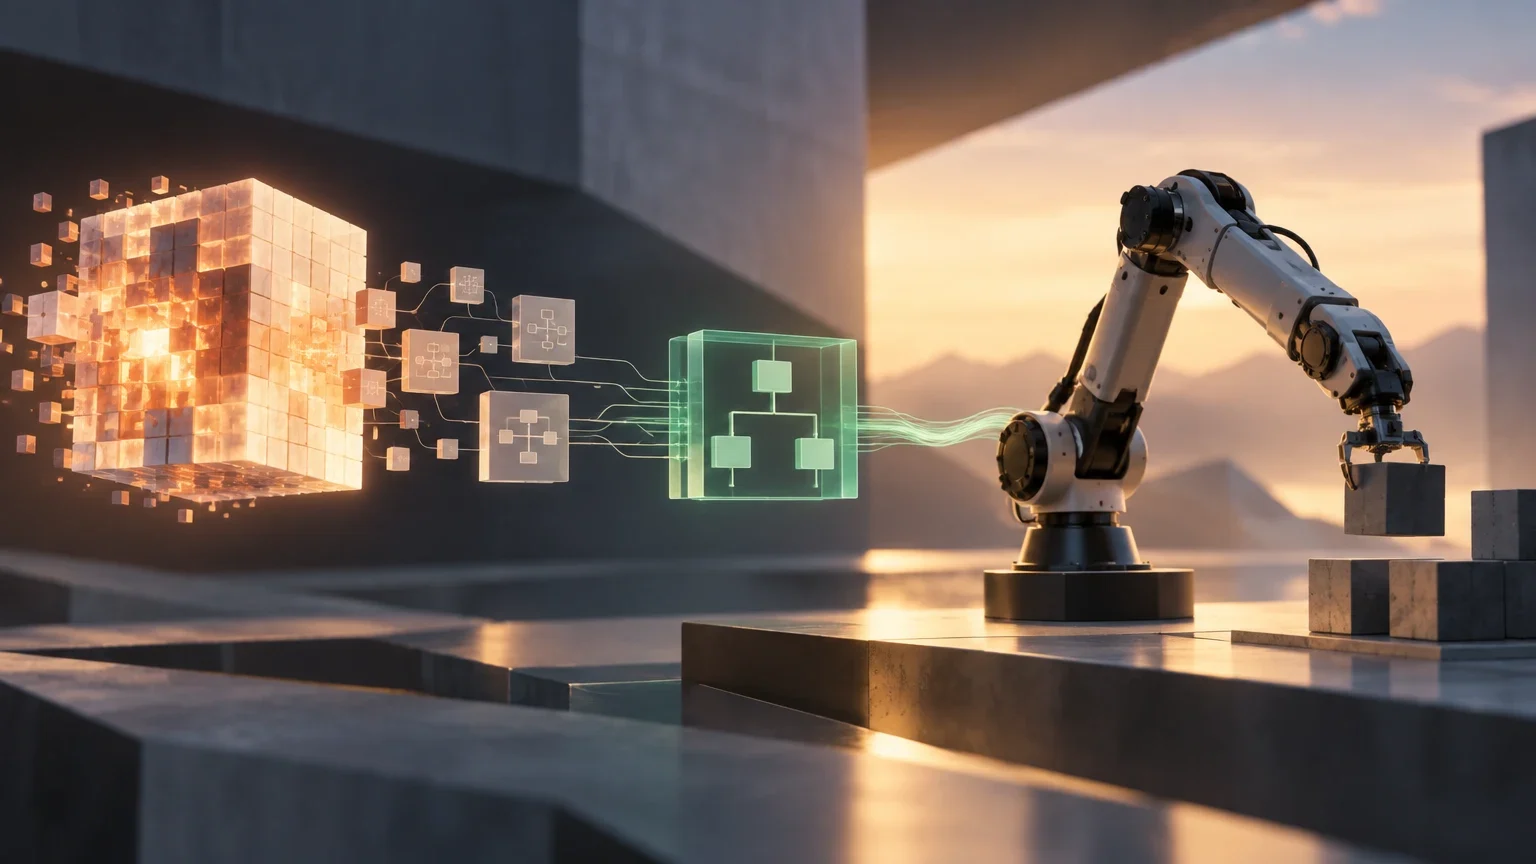
Code to Control separa la generazione della struttura di un controllore dalla regolazione dei suoi parametri. Il preprint sostiene che, una volta appreso, il controllore può agire senza inferenza dell’LLM né pianificazione a ogni passo; le informazioni disponibili non bastano per valutare i risultati numerici, la riproducibilità o la preparazione all’uso su robot reali.
ElevenLabs descrive Eleven v4 come il proprio modello di sintesi vocale più espressivo e dotato di maggiore controllo. Questa caratterizzazione proviene dal produttore: da sola non quantifica la qualità né dimostra che i risultati siano coerenti. Ecco che cosa consentono di affermare le fonti disponibili e che cosa un team dovrebbe ancora verificare.