Un média fait état d’une citation liée à des incidents de cybersécurité impliquant des agents d’IA. Les éléments disponibles ne permettent pas de confirmer l’épisode de Hugging Face, l’étendue de l’accès ni l’existence d’une extraction de données ou de dommages.
Deux publications décrivent des modèles Microsoft de transcription en streaming et de synthèse vocale. La documentation fournie confirme une partie du contexte, mais ne vérifie pas indépendamment les chiffres de latence ni la portée des 23 langues annoncées.
Selon ses auteurs, la méthode réduit le taux de réussite des portes dérobées sans réentraîner les paramètres suspects et sans dépendre, d’après le résumé, de déclencheurs connus ni de références propres. Les détails expérimentaux disponibles ne permettent pas de vérifier ces affirmations de manière indépendante.
Une analyse de 22 benchmarks distingue la fiabilité de la comparaison de systèmes déployés de celle qui consiste à attribuer les différences aux modèles. Ses résultats indiquent que davantage de tâches ne dissipe pas toutes les incertitudes.
Un guide pratique pour transformer les réponses d’un modèle en données qu’une application peut vérifier et exploiter. Apprenez à définir un contrat, à valider séparément le format et le sens, à prévoir les erreurs et à tester les cas limites avant le déploiement.
Un guide opérationnel pour gérer les ajouts, modifications et suppressions dans un corpus RAG, tracer la provenance des documents et vérifier que les mises à jour se reflètent dans les recherches.
Google présente Gemini 3.8 Live comme un modèle de dialogue en temps réel, mais les sources disponibles ne permettent de confirmer ni un tarif, ni des résultats quantitatifs, ni l’ensemble des conditions d’accès. Ce guide distingue les affirmations du fournisseur des vérifications qu’une équipe doit effectuer dans sa propre intégration.
Google présente Gemini 3.8 Live Extended Thinking comme un modèle audio-à-audio pour Live API, recommandé lorsqu’un raisonnement plus approfondi en arrière-plan est nécessaire. La documentation disponible ne démontre pas à elle seule que cette fonction réduise les erreurs ou améliore la latence : ces questions doivent être évaluées à l’aide de tâches et de conditions contrôlées.
ElevenLabs présente v4 Turbo comme une variante à faible latence et publie une latence médiane d’inférence proche de 100 ms. Ce chiffre ne correspond pas au temps de réponse d’un agent complet : la méthode de mesure, les conditions d’accès, le coût applicable et les éléments de sécurité propres au modèle restent à préciser.
Les sources disponibles renvoient à des évaluations du fournisseur, à une fiche système et à une étude indépendante sur les agents IDE, mais elles ne fournissent pas assez de détails pour les traiter comme un classement commun. Ce guide distingue les éléments établis de ceux qui restent à vérifier.
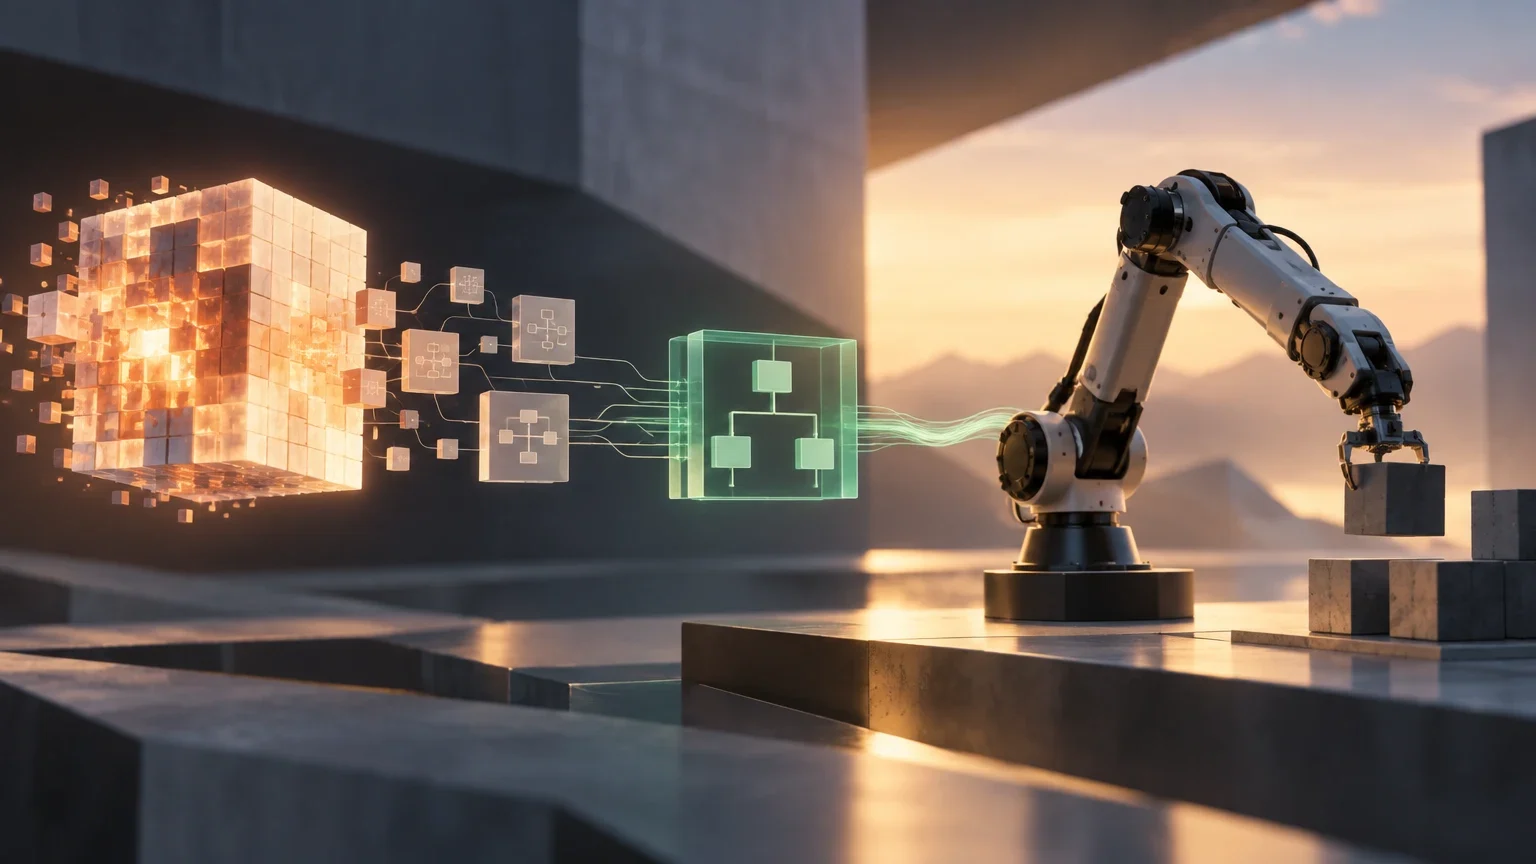
Code to Control sépare la génération de la structure d’un contrôleur du réglage de ses paramètres. Le préprint affirme qu’une fois appris, le contrôleur peut agir sans inférence du LLM ni planification à chaque étape ; les éléments disponibles ne suffisent pas à évaluer les chiffres, la reproductibilité ou l’aptitude à contrôler des robots réels.
ElevenLabs présente Eleven v4 comme son modèle de synthèse vocale le plus expressif et celui qui offre le plus de contrôle. Cette caractérisation vient du fabricant : à elle seule, elle ne quantifie pas la qualité et ne démontre pas la régularité des résultats. Voici ce que les sources disponibles permettent d’affirmer et ce qu’une équipe doit encore vérifier.