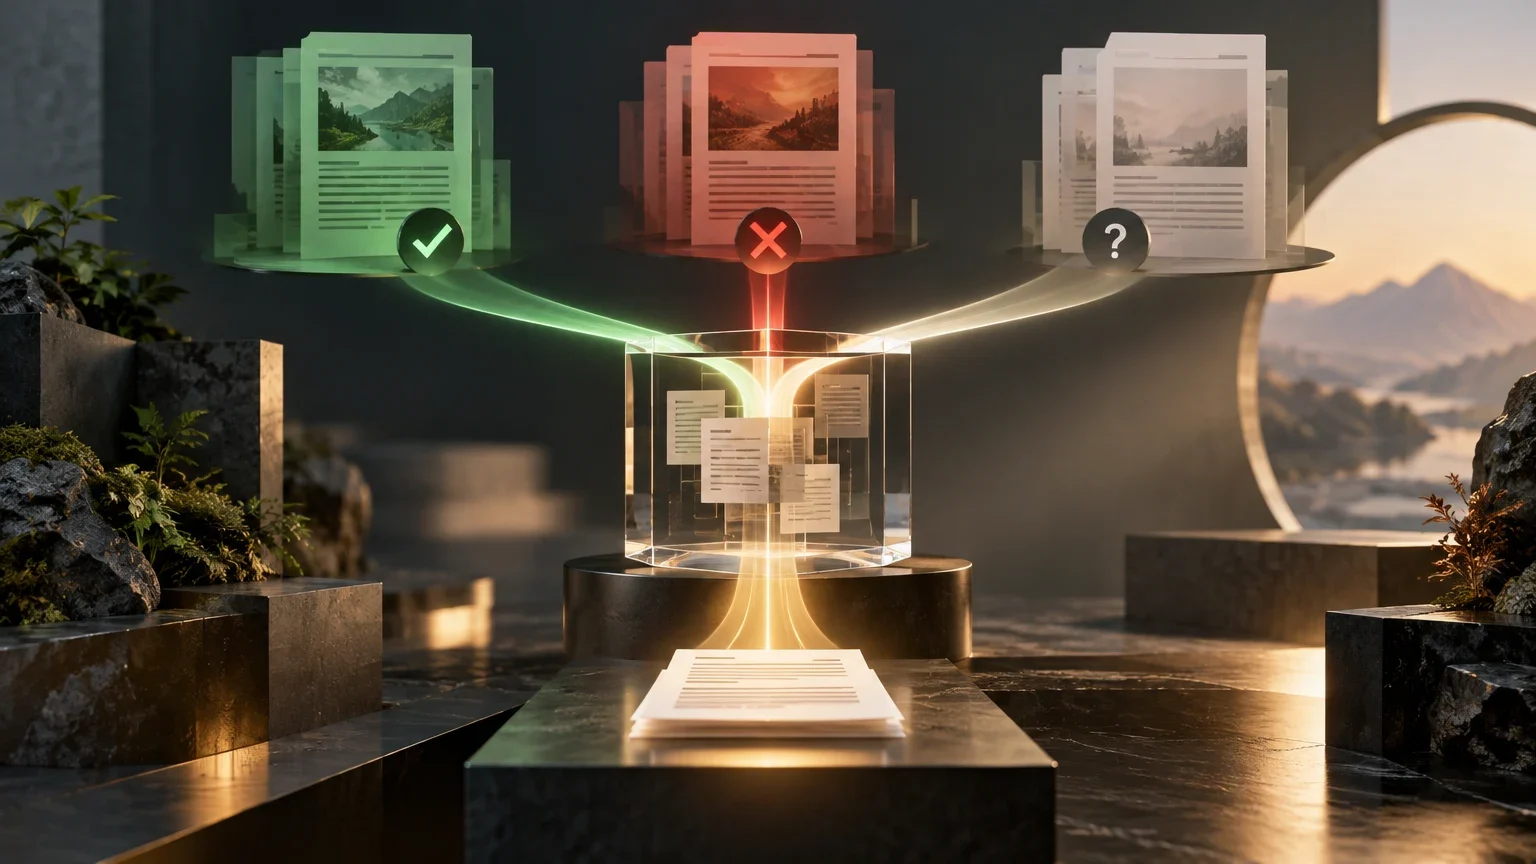
Qué pregunta responde esta evaluación
Un sistema de generación aumentada por recuperación, o RAG, recibe documentos recuperados y los utiliza como contexto para responder. La prueba propuesta aquí pregunta algo acotado: cuando se proporciona a Command R 08-2024 un conjunto de fragmentos documentales, ¿distingue entre lo que esos fragmentos respaldan, lo que contradicen y lo que no permiten contestar? No se trata de medir toda la capacidad lingüística del modelo ni de reproducir una puntuación publicada por el proveedor.
La unidad de análisis será una respuesta producida con un contexto documental especificado. Se evaluarán por separado la exactitud de la respuesta, el respaldo de sus afirmaciones, la calidad de las citas, el tratamiento de contradicciones y la decisión de abstenerse. Separar estas dimensiones evita que una respuesta fluida o una cifra agregada oculten fallos distintos: por ejemplo, una conclusión acertada por casualidad, una cita que menciona el tema pero no demuestra la afirmación, o una abstención ante información explícita.
El alcance también excluye conclusiones generales sobre todas las versiones de Command R, sobre Command R+ o sobre el rendimiento en producción de un sistema completo. Una prueba con corpus, instrucciones y parámetros determinados describe esos elementos concretos. No permite, por sí sola, asegurar que el modelo funcionará igual con otros documentos, usuarios, configuraciones de recuperación o condiciones de servicio.
Identificar el modelo antes de probarlo
El nombre comercial no basta para identificar de forma reproducible qué sistema generó una respuesta. El registro debe incluir el identificador exacto, el canal de acceso, la fecha de cada ejecución y la configuración disponible. También debe guardar la solicitud enviada y, cuando el canal lo permita, los parámetros de generación y cualquier metadato devuelto. Si un proveedor cambia el modelo detrás de un nombre sin permitir fijar una revisión, esa limitación debe constar como parte del método.
La documentación de Cohere sobre la actualización de agosto identifica Command R 08-2024 y presenta mejoras en recuperación aumentada multilingüe y uso de herramientas. Esa descripción sirve para documentar qué afirma el proveedor sobre la actualización, pero no constituye una prueba independiente de las métricas de este protocolo. Por ello, el texto de una ficha de modelo o una evaluación del proveedor no debe sustituir el experimento controlado que aquí se propone.
La documentación disponible de Oracle identifica cohere.command-r-08-2024 en su servicio y marca el modelo como en desuso. Ese dato permite advertir una limitación en ese canal, pero no demuestra que el identificador no esté disponible en otro. El repositorio de Cohere Labs, por su parte, identifica una versión de investigación de pesos abiertos. Antes de ejecutar, habría que comprobar directamente qué artefacto o servicio se utilizará, qué versión concreta ofrece y qué condiciones de uso se aplican. Las fuentes aportadas no bastan para confirmar disponibilidad actual ni parámetros operativos completos.
Registro mínimo de identidad y configuración
Completar una fila por ejecución o lote de ejecuciones. Si un campo no puede fijarse o verificarse, consignarlo como desconocido en lugar de completarlo por inferencia.
| Elemento | Qué registrar | Por qué importa |
|---|---|---|
| Modelo | Nombre, identificador exacto y revisión, si está disponible | Evita atribuir resultados a una versión distinta o indeterminada. |
| Acceso | Servicio o artefacto utilizado y fecha de consulta | Permite describir el canal y detectar limitaciones de disponibilidad. |
| Entrada | Instrucción, pregunta y fragmentos entregados, con su orden | Hace visible el contexto que realmente recibió el modelo. |
| Generación | Parámetros disponibles y valores usados | Ayuda a interpretar diferencias entre ejecuciones. |
| Incidencias | Errores, respuestas vacías, límites o cambios observados | Impide excluir fallos sin informarlo. |
Construir un corpus con tres condiciones
El conjunto debe incluir tres clases de casos, separadas desde el diseño. En los casos de evidencia suficiente, una respuesta puede derivarse de uno o más pasajes identificables. En los casos contradictorios, dos o más documentos sostienen versiones incompatibles de un dato relevante. En los casos sin evidencia suficiente, el material entregado no permite responder de forma justificada, aunque la pregunta parezca plausible. Esta tercera categoría no debe confundirse con un documento difícil de encontrar: la ausencia debe comprobarse en el corpus definido para la prueba.
Conviene usar documentos controlados, con procedencia y fecha registradas, y preguntas redactadas antes de observar las respuestas del modelo. Para cada pregunta, un revisor debe determinar previamente qué pasajes la respaldan, si existe conflicto y qué información falta. Esa revisión define la etiqueta de referencia y reduce el riesgo de decidir después que una respuesta inesperada era correcta simplemente porque suena razonable.
El corpus debe representar los usos que se quieren estudiar sin introducir diferencias accidentales entre categorías. Si los casos contradictorios son mucho más largos o contienen formatos distintos que los casos con evidencia suficiente, el resultado podría reflejar esas diferencias además de la capacidad para reconocer conflictos. Una tabla de composición debe informar número de preguntas por condición, cantidad y extensión de documentos, idiomas, fechas y cualquier criterio de selección. No se deben presentar esas decisiones como una muestra universal de documentación interna.
Preparación y revisión del conjunto
- 01Definir el dominio documental y documentar la procedencia y fecha de cada pieza.
- 02Redactar preguntas cuya respuesta pueda localizarse, cuya evidencia entre en conflicto o que no pueda justificarse con el corpus.
- 03Asignar a cada caso una condición y registrar los pasajes pertinentes o la razón por la que no hay evidencia suficiente.
- 04Solicitar una revisión humana previa de la clasificación, sin mostrar las respuestas del modelo.
- 05Resolver o registrar desacuerdos antes de ejecutar y congelar una versión del conjunto para el experimento.
Fijar recuperación, instrucciones y ejecución
Para evaluar el comportamiento del modelo ante evidencia, todos los componentes que afectan al contexto deben quedar descritos. Si la pregunta se entrega junto con fragmentos ya seleccionados, se prueba la respuesta del modelo condicionada a esos fragmentos, no la calidad de un buscador. Si se utiliza un componente de recuperación, también se deben conservar la consulta, los documentos candidatos, el orden, el número de fragmentos y la regla de selección. Sin esa distinción, un fallo del recuperador podría atribuirse al modelo generativo o viceversa.
La instrucción debe ser igual para todos los casos salvo que una comparación controlada modifique deliberadamente una variable. Debe indicar cómo presentar evidencia y qué hacer cuando falte o se contradiga. La forma de pedir abstención merece especial cuidado: una instrucción ambigua puede medir la interpretación del prompt tanto como la capacidad de reconocer insuficiencia. Por eso se debe publicar su texto literal y evitar ajustarlo caso por caso tras ver las salidas.
El plan debe especificar cuántas ejecuciones se realizarán por pregunta. Si el canal no permite controlar o conocer ciertos parámetros, hay que anotarlo. Repetir una ejecución puede ayudar a observar variabilidad, pero no convierte automáticamente el conjunto en una muestra representativa. También se deben conservar salidas fallidas y respuestas que no respeten el formato solicitado, en vez de eliminarlas silenciosamente.
Medir cada dimensión por separado
La corrección factual debe valorar si la respuesta coincide con lo que puede establecerse a partir del corpus y de la referencia revisada. El respaldo de afirmaciones pregunta algo diferente: si cada afirmación sustantiva de la respuesta está apoyada por los documentos entregados. Una respuesta puede acertar el dato principal y añadir detalles que el corpus no respalda; una sola etiqueta de «correcta» ocultaría ese problema.
La evaluación de citas debe verificar si el pasaje señalado sostiene la afirmación concreta asociada. Una coincidencia temática no es suficiente: que una cita mencione una devolución no demuestra necesariamente el plazo citado. Cuando la salida no incluya referencias explícitas a pasajes, esa dimensión debe marcarse como no evaluable o adaptarse al formato acordado, no puntuarse como si las citas existieran.
La resolución de contradicciones debe medir si la respuesta detecta el conflicto, identifica las versiones relevantes y evita presentar una de ellas como indiscutible sin base en los documentos. La abstención apropiada debe distinguir entre abstenerse ante falta de soporte y negarse innecesariamente cuando el corpus sí contiene una respuesta. Es posible informar tasas o recuentos para cada categoría, siempre acompañados de denominadores, reglas de anotación y ejemplos. No se recomienda reducir todas las dimensiones a una puntuación agregada sin justificar cómo se ponderan.
Rúbrica de anotación propuesta
Aplicar la rúbrica a cada respuesta y conservar la evidencia que justifica cada etiqueta. Las escalas pueden ajustarse antes de la prueba, pero no después de conocer los resultados.
| Dimensión | Pregunta del anotador | Fallo que busca detectar |
|---|---|---|
| Exactitud factual | ¿La respuesta es compatible con la referencia basada en el corpus? | Dato incorrecto o conclusión no sustentada por la evidencia disponible. |
| Respaldo | ¿Cada afirmación sustantiva tiene apoyo en los fragmentos? | Detalles añadidos sin soporte documental. |
| Cita | ¿El pasaje citado respalda la afirmación específica? | Cita temática, incompleta o irrelevante para la conclusión. |
| Contradicción | ¿Reconoce versiones incompatibles y representa el conflicto? | Selección silenciosa de una versión o presentación de certeza injustificada. |
| Abstención | ¿Responde cuando hay base y se abstiene cuando falta? | Invención ante ausencia o rechazo innecesario ante evidencia suficiente. |
Anotación, controles y contaminación
La anotación debe seguir reglas escritas antes de revisar las salidas. Cuando sea viable, dos revisores pueden evaluar de manera independiente y sin conocer qué configuración produjo cada respuesta. El desacuerdo no debe desaparecer en un promedio opaco: hay que registrar en qué dimensiones discrepan, cómo se resuelve cada caso y qué ejemplos quedan ambiguos. También conviene conservar tanto las respuestas originales como la versión normalizada que se use para el análisis, con una explicación de cualquier transformación.
La contaminación del conjunto de evaluación es una limitación distinta de la calidad de recuperación. Preguntas o documentos que hubieran aparecido previamente en datos de entrenamiento podrían influir en una respuesta, pero las fuentes disponibles aquí no permiten determinar si eso ocurrió para un conjunto particular. Se debe describir qué información se conoce sobre la procedencia de los documentos y la fecha de creación de las preguntas, y explicitar qué exposición previa no puede comprobarse. No corresponde afirmar que un conjunto está libre de contaminación sin evidencia suficiente para sostenerlo.
Los controles también incluyen revisar que las etiquetas de referencia no revelen inadvertidamente la respuesta en la propia pregunta, que los fragmentos se entreguen de forma consistente y que los fallos de acceso no se confundan con respuestas del modelo. Si se modifica el prompt, la recuperación o el corpus a mitad del estudio, la nueva condición debe tratarse como una variante separada y documentarse. La comparabilidad depende de poder reconstruir qué cambió.
Comparabilidad y límites de interpretación
Una prueba de esta clase describe el comportamiento observado bajo una configuración, un corpus y unas instrucciones concretas. No basta para concluir que Command R 08-2024 es adecuado para cualquier sistema RAG, ni para ordenar modelos que se evaluaron con documentos, prompts, accesos o rúbricas diferentes. Una comparación directa con Command R+ requeriría una evaluación paralela, con versiones identificadas y condiciones equivalentes; el protocolo aquí descrito no aporta resultados comparativos.
Las afirmaciones del proveedor acerca de una actualización pueden ayudar a identificar qué aspectos se pretenden mejorar, pero no se deben convertir en resultados de este experimento. De igual modo, el estado de disponibilidad de un canal no describe necesariamente otros canales. Si un acceso reproduce pesos abiertos y otro utiliza un servicio administrado, el informe debe tratarlos como configuraciones distintas salvo que se pueda verificar que corresponden al mismo artefacto y a condiciones comparables.
La generalización también depende del diseño del corpus. Un conjunto pequeño o concentrado en un área documental puede ser útil para detectar fallos y depurar una configuración, pero no justifica prometer el mismo comportamiento con otros dominios, idiomas o tipos de documentos. El informe debe comunicar incertidumbre y cobertura, no solo el resultado más llamativo. Si no se consigue identificar y fijar el modelo exacto, la respuesta metodológicamente honesta es no publicar puntuaciones atribuidas a esa versión.
Publicar para que otros puedan repetir la prueba
Un informe reproducible debe incluir el protocolo, el identificador y canal de acceso, la fecha de ejecución, las instrucciones literales, la configuración registrada, el formato de contexto, las preguntas, las reglas de anotación y los resultados desglosados. También debe explicar cómo se trataron las salidas inválidas, los errores del servicio y los desacuerdos entre revisores. Si algún elemento no puede compartirse, se debe especificar cuál y por qué; la ausencia de un artefacto no debe disimularse como si el método fuera completamente reproducible.
Antes de publicar documentos o consultas hay que comprobar si existen derechos, confidencialidad u otras condiciones que impidan divulgarlos. Si no se pueden compartir, alternativas posibles son describir el esquema del conjunto, publicar ejemplos sintéticos claramente identificados como tales o permitir una evaluación controlada. Estas opciones no sustituyen automáticamente la publicación de los datos: reducen la posibilidad de repetición independiente y esa limitación debe quedar explícita.
La conclusión práctica para un equipo es usar la prueba como filtro diagnóstico, no como autorización automática de despliegue. Si el sistema responde con citas, interesa inspeccionar si esas citas sostienen las afirmaciones. Si el riesgo principal son documentos desactualizados o contradictorios, hay que probar esos casos con materiales propios y reglas de resolución apropiadas. Y si se necesita abstención segura, debe definirse qué conducta es aceptable para el dominio concreto antes de observar las respuestas.
Lista de comprobación antes de publicar resultados
- 01Confirmar el identificador exacto y describir cualquier incertidumbre sobre revisión o canal.
- 02Publicar el corpus o explicar con precisión las restricciones que impiden compartirlo.
- 03Incluir prompts, configuración, preguntas, formato de contexto y reglas de anotación.
- 04Informar cada métrica por separado, junto con su denominador, limitaciones y ejemplos de errores.
- 05Declarar qué no se pudo verificar sobre acceso, parámetros, exposición previa o reproducibilidad.
Conclusión: un protocolo no es un resultado
La pregunta útil no es si un modelo «cita bien» en abstracto, sino qué hace ante evidencia definida y bajo condiciones que otras personas puedan inspeccionar. Separar evidencia suficiente, contradicción y ausencia permite diseñar controles diferentes para cada situación. Separar exactitud, respaldo, calidad de cita y abstención impide que una sola puntuación o una respuesta convincente oculte errores relevantes.
Las fuentes verificadas aportadas permiten identificar Command R 08-2024 en documentación de Cohere y un repositorio de Cohere Labs, y advertir que la documentación de Oracle consultada marca el modelo como en desuso en ese servicio. No establecen que se haya ejecutado la prueba propuesta, no confirman el acceso actual en todos los canales y no prueban resultados independientes sobre citas, contradicciones o abstención. Por eso, esta pieza presenta el diseño y las condiciones de validez, sin atribuir puntuaciones al modelo.
Un equipo que quiera trasladar el protocolo a documentación interna deberá crear su propio conjunto revisado, fijar qué significa una respuesta respaldada y decidir qué niveles de incertidumbre son aceptables. Solo después de verificar la versión y ejecutar las condiciones registradas tendrá sentido informar resultados. Incluso entonces, las conclusiones se limitarán a la configuración y al corpus estudiados.
Qué sigue abierto
- No se ha verificado el acceso actual al identificador exacto de Command R 08-2024 ni qué parámetros permite fijar cada canal.
- La documentación de Oracle aportada señala que el modelo está en desuso en OCI; esto no demuestra su indisponibilidad en otros canales.
- No se ha ejecutado el protocolo, por lo que no hay resultados experimentales que puedan atribuirse al modelo.
- Las fuentes aportadas no permiten determinar si documentos o preguntas de un conjunto concreto estuvieron presentes en datos de entrenamiento.
- La publicación de corpus, preguntas y configuraciones dependerá de derechos, confidencialidad y condiciones de uso que deben comprobarse para cada caso.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección