À quelle question cette évaluation répond-elle ?
Un système de génération augmentée par récupération, ou RAG, reçoit des documents récupérés et s’en sert comme contexte pour répondre. Le test proposé ici pose une question circonscrite : lorsqu’on fournit à Command R 08-2024 un ensemble d’extraits documentaires, le modèle distingue-t-il ce que ces extraits étayent, ce qu’ils contredisent et ce qu’ils ne permettent pas de déterminer ? Il ne s’agit ni de mesurer toutes les capacités linguistiques du modèle ni de reproduire un score publié par le fournisseur.
L’unité d’analyse sera une réponse produite à partir d’un contexte documentaire défini. L’évaluation portera séparément sur l’exactitude de la réponse, l’étayage de ses affirmations, la qualité des citations, le traitement des contradictions et la décision de s’abstenir. Séparer ces dimensions évite qu’une réponse fluide ou un score agrégé masque des défaillances différentes : par exemple, une conclusion exacte par hasard, une citation qui mentionne le sujet sans démontrer l’affirmation, ou une abstention alors que l’information est explicite.
Le périmètre exclut également toute conclusion générale sur l’ensemble des versions de Command R, sur Command R+ ou sur les performances en production d’un système complet. Un test mené avec un corpus, des instructions et des paramètres donnés décrit ces éléments précis. À lui seul, il ne permet pas d’affirmer que le modèle se comportera de la même manière avec d’autres documents, d’autres utilisateurs, d’autres configurations de récupération ou d’autres conditions de service.
Identifier le modèle avant de le tester
Le nom commercial ne suffit pas à identifier de manière reproductible le système qui a généré une réponse. Le relevé doit indiquer l’identifiant exact, le canal d’accès, la date de chaque exécution et la configuration disponible. Il doit également conserver la requête envoyée et, lorsque le canal le permet, les paramètres de génération ainsi que toute métadonnée renvoyée. Si un fournisseur modifie le modèle derrière un même nom sans permettre de fixer une révision, cette limite doit être signalée dans la méthode.
La documentation de Cohere sur la mise à jour d’août identifie Command R 08-2024 et présente des améliorations en génération augmentée par récupération multilingue et en utilisation d’outils. Cette description permet de consigner ce que le fournisseur affirme au sujet de la mise à jour, mais elle ne constitue pas une validation indépendante des mesures du protocole proposé ici. Une fiche de modèle ou une évaluation du fournisseur ne doit donc pas remplacer l’expérience contrôlée proposée dans cet article.
La documentation Oracle consultée identifie cohere.command-r-08-2024 dans son service et indique que le modèle est obsolète. Cette information permet de signaler une limite sur ce canal, mais ne démontre pas que l’identifiant soit indisponible ailleurs. Le dépôt de Cohere Labs identifie, quant à lui, une version de recherche à poids ouverts. Avant toute exécution, il faudrait vérifier directement quel artefact ou service sera utilisé, quelle version précise il propose et quelles conditions d’utilisation s’appliquent. Les sources disponibles ne suffisent pas à confirmer la disponibilité actuelle ni l’ensemble des paramètres opérationnels.
Relevé minimal de l’identité et de la configuration
Remplir une ligne pour chaque exécution ou lot d’exécutions. Si un champ ne peut être fixé ou vérifié, le noter comme inconnu plutôt que de le compléter par déduction.
| Élément | Informations à consigner | Pourquoi c’est important |
|---|---|---|
| Modèle | Nom, identifiant exact et révision, si elle est disponible | Évite d’attribuer les résultats à une version différente ou indéterminée. |
| Accès | Service ou artefact utilisé et date de consultation | Permet de décrire le canal et de détecter les limites de disponibilité. |
| Entrée | Instruction, question et extraits fournis, avec leur ordre | Rend visible le contexte réellement reçu par le modèle. |
| Génération | Paramètres disponibles et valeurs utilisées | Aide à interpréter les différences entre les exécutions. |
| Incidents | Erreurs, réponses vides, limites ou changements observés | Évite que des échecs soient exclus sans être signalés. |
Construire un corpus couvrant trois situations
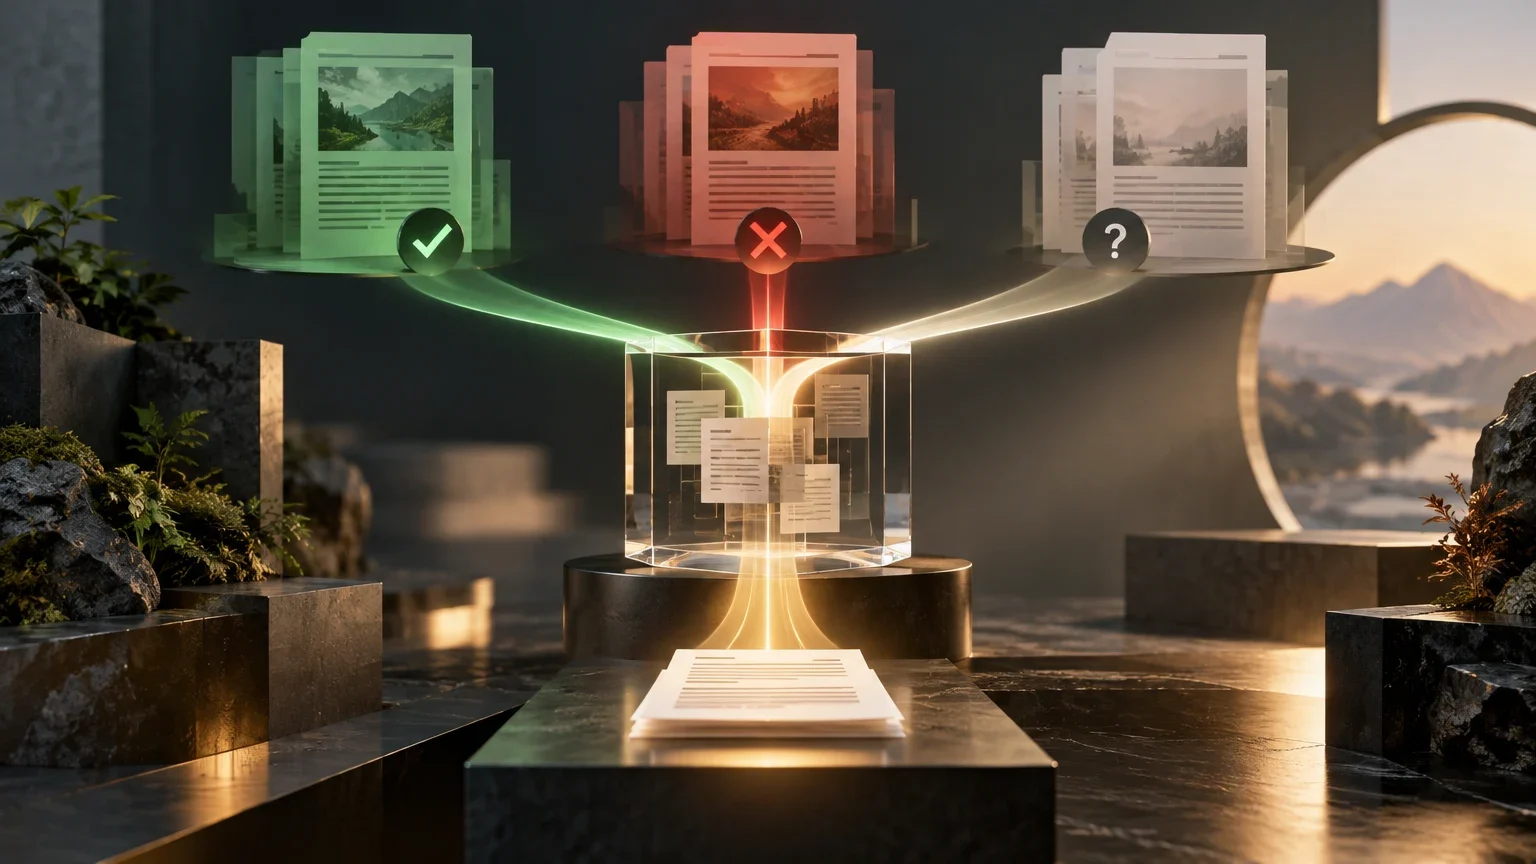
Le jeu de données doit inclure dès sa conception trois catégories de cas, maintenues séparées. Dans les cas où les preuves sont suffisantes, une réponse peut être déduite d’un ou de plusieurs passages identifiables. Dans les cas contradictoires, au moins deux documents présentent des versions incompatibles d’une information pertinente. Dans les cas où les preuves sont insuffisantes, les documents fournis ne permettent pas de répondre de façon justifiée, même si la question paraît plausible. Cette troisième catégorie ne doit pas être confondue avec un document difficile à retrouver : l’absence doit être vérifiée au sein du corpus défini pour le test.
Il est préférable d’utiliser des documents contrôlés, dont la provenance et la date sont consignées, et de rédiger les questions avant d’observer les réponses du modèle. Pour chaque question, une personne chargée de la revue doit déterminer au préalable quels passages l’étayent, s’il existe une contradiction et quelles informations manquent. Cette vérification établit la référence et réduit le risque de décider après coup qu’une réponse inattendue est correcte simplement parce qu’elle paraît raisonnable.
Le corpus doit représenter les usages que l’on souhaite étudier sans introduire de différences accidentelles entre les catégories. Si les cas contradictoires sont beaucoup plus longs ou présentent des formats différents des cas où les preuves sont suffisantes, les résultats pourraient refléter ces écarts autant que la capacité à reconnaître les conflits. Un tableau décrivant la composition doit indiquer le nombre de questions par situation, la quantité et la longueur des documents, les langues, les dates et les critères de sélection. Ces choix ne doivent pas être présentés comme un échantillon universel de la documentation interne.
Préparer et réviser le jeu de données
- 01Définir le domaine documentaire et consigner la provenance et la date de chaque document.
- 02Rédiger des questions dont la réponse peut être localisée, dont les preuves sont contradictoires ou qui ne peuvent pas être justifiées par le corpus.
- 03Attribuer à chaque cas une catégorie et consigner les passages pertinents ou la raison pour laquelle les preuves sont insuffisantes.
- 04Faire vérifier au préalable la classification par une personne, sans lui montrer les réponses du modèle.
- 05Résoudre les désaccords ou les consigner avant l’exécution, puis figer une version du jeu de données pour l’expérience.
Fixer la récupération, les instructions et l’exécution
Pour évaluer le comportement du modèle face aux preuves, tous les éléments qui influencent le contexte doivent être décrits. Si la question est fournie avec des extraits déjà sélectionnés, le test porte sur la réponse du modèle conditionnée par ces extraits, et non sur la qualité d’un moteur de recherche. Si un composant de récupération est utilisé, il faut également conserver la requête, les documents candidats, leur ordre, le nombre d’extraits et la règle de sélection. Sans cette distinction, un échec du système de récupération pourrait être imputé au modèle génératif, ou inversement.
Les instructions doivent rester identiques pour tous les cas, sauf si une comparaison contrôlée modifie délibérément une variable. Elles doivent préciser comment présenter les preuves et quoi faire lorsqu’elles manquent ou se contredisent. La consigne d’abstention mérite une attention particulière : une instruction ambiguë peut mesurer l’interprétation du prompt autant que la capacité à reconnaître une insuffisance. Il faut donc en publier le texte exact et éviter de l’ajuster au cas par cas après avoir observé les sorties.
Le plan doit préciser le nombre d’exécutions par question. Si le canal ne permet pas de contrôler ou de connaître certains paramètres, il faut le noter. Répéter une exécution peut aider à observer la variabilité, mais ne transforme pas automatiquement le jeu de données en échantillon représentatif. Il faut aussi conserver les sorties en échec et les réponses qui ne respectent pas le format demandé, plutôt que de les supprimer discrètement.
Mesurer séparément chaque dimension
L’exactitude factuelle doit évaluer si la réponse correspond à ce qui peut être établi à partir du corpus et de la référence vérifiée. L’étayage des affirmations pose une autre question : chaque affirmation substantielle de la réponse est-elle soutenue par les documents fournis ? Une réponse peut donner le bon fait principal tout en ajoutant des détails que le corpus n’étaye pas ; une simple étiquette « correcte » masquerait ce problème.
L’évaluation des citations doit vérifier si le passage indiqué soutient l’affirmation précise qui lui est associée. Une simple proximité thématique ne suffit pas : le fait qu’une citation mentionne un retour ne prouve pas nécessairement le délai indiqué. Si la sortie ne comporte pas de références explicites à des passages, cette dimension doit être marquée comme non évaluable ou adaptée au format convenu, et non notée comme si des citations étaient présentes.
L’évaluation de la résolution des contradictions doit mesurer si la réponse repère le conflit, identifie les versions pertinentes et évite de présenter l’une d’elles comme incontestable sans fondement dans les documents. L’abstention appropriée doit distinguer l’abstention face à un manque de preuves du refus inutile de répondre lorsque le corpus contient bien une réponse. Il est possible de présenter des taux ou des décomptes pour chaque catégorie, à condition de les accompagner des dénominateurs, des règles d’annotation et d’exemples. Il est déconseillé de réduire toutes les dimensions à un score agrégé sans justifier leur pondération.
Grille d’annotation proposée
Appliquer la grille à chaque réponse et conserver les éléments qui justifient chaque étiquette. Les échelles peuvent être ajustées avant le test, mais pas après avoir pris connaissance des résultats.
| Dimension | Question posée à la personne chargée de l’annotation | Défaillance recherchée |
|---|---|---|
| Exactitude factuelle | La réponse est-elle compatible avec la référence établie à partir du corpus ? | Information erronée ou conclusion non soutenue par les preuves disponibles. |
| Étayage | Chaque affirmation substantielle est-elle soutenue par les extraits ? | Détails ajoutés sans appui documentaire. |
| Citation | Le passage cité soutient-il l’affirmation précise ? | Citation thématique, incomplète ou sans rapport avec la conclusion. |
| Contradiction | La réponse reconnaît-elle les versions incompatibles et rend-elle compte du conflit ? | Choix silencieux d’une version ou certitude injustifiée. |
| Abstention | La réponse est-elle donnée lorsqu’il existe un fondement, et le modèle s’abstient-il lorsqu’il en manque ? | Invention en l’absence de preuves ou refus inutile malgré des preuves suffisantes. |
Annotation, contrôles et contamination
L’annotation doit suivre des règles écrites avant l’examen des sorties. Lorsque c’est possible, deux personnes peuvent évaluer les réponses de manière indépendante, sans savoir quelle configuration a produit chaque réponse. Les désaccords ne doivent pas disparaître dans une moyenne opaque : il faut consigner les dimensions concernées, la manière dont chaque cas est résolu et les exemples qui demeurent ambigus. Il est également utile de conserver les réponses originales ainsi que la version normalisée utilisée pour l’analyse, en expliquant toute transformation.
La contamination du jeu d’évaluation est une limite distincte de la qualité de la récupération. Des questions ou des documents déjà présents dans les données d’entraînement pourraient influencer une réponse, mais les sources disponibles ici ne permettent pas de déterminer si cela s’est produit pour un jeu de données donné. Il faut décrire ce que l’on sait de la provenance des documents et de la date de création des questions, et préciser quelle exposition antérieure ne peut pas être vérifiée. Il ne convient pas d’affirmer qu’un jeu de données est exempt de contamination sans disposer de preuves suffisantes.
Les contrôles doivent aussi vérifier que les références ne révèlent pas involontairement la réponse dans la question elle-même, que les extraits sont fournis de manière cohérente et que les échecs d’accès ne sont pas confondus avec les réponses du modèle. Si le prompt, la récupération ou le corpus change en cours d’étude, la nouvelle condition doit être traitée comme une variante distincte et documentée. La comparabilité dépend de la possibilité de reconstituer ce qui a changé.
Comparabilité et limites de l’interprétation
Un test de ce type décrit le comportement observé avec une configuration, un corpus et des instructions précis. Il ne suffit pas à conclure que Command R 08-2024 convient à tout système RAG, ni à classer des modèles évalués avec des documents, des prompts, des accès ou des grilles différents. Une comparaison directe avec Command R+ nécessiterait une évaluation parallèle, avec des versions identifiées et des conditions équivalentes ; le protocole présenté ici ne fournit pas de résultats comparatifs.
Les déclarations du fournisseur au sujet d’une mise à jour peuvent aider à identifier les aspects que celle-ci vise à améliorer, mais elles ne doivent pas être transformées en résultats de cette expérience. De même, la disponibilité sur un canal donné ne décrit pas nécessairement la disponibilité sur d’autres canaux. Si un accès utilise des poids ouverts et un autre un service géré, le rapport doit les traiter comme des configurations distinctes, sauf si l’on peut vérifier qu’ils correspondent au même artefact et à des conditions comparables.
La portée des conclusions dépend aussi de la conception du corpus. Un petit jeu de données ou un jeu concentré sur un domaine documentaire peut être utile pour détecter des défaillances et ajuster une configuration, mais il ne justifie pas de promettre le même comportement dans d’autres domaines, langues ou types de documents. Le rapport doit rendre compte de l’incertitude et de la couverture, et pas seulement du résultat le plus frappant. Si l’identification et le verrouillage du modèle exact ne sont pas possibles, la position méthodologiquement honnête consiste à ne pas publier de scores attribués à cette version.
Publier de façon à permettre la reproduction du test
Un rapport reproductible doit inclure le protocole, l’identifiant du modèle et le canal d’accès, la date d’exécution, le texte exact des instructions, la configuration consignée, le format du contexte, les questions, les règles d’annotation et les résultats ventilés par dimension. Il doit aussi expliquer le traitement des sorties invalides, des erreurs de service et des désaccords entre les personnes chargées de l’examen. Si un élément ne peut être partagé, il faut préciser lequel et pourquoi ; l’absence d’un artefact ne doit pas être dissimulée en donnant à croire que la méthode est entièrement reproductible.
Avant de publier des documents ou des requêtes, il faut vérifier si des droits, des obligations de confidentialité ou d’autres conditions en empêchent la divulgation. Si le partage est impossible, on peut envisager de décrire la structure du jeu de données, de publier des exemples synthétiques clairement identifiés comme tels ou de proposer une évaluation contrôlée. Ces solutions ne remplacent pas automatiquement la publication des données : elles réduisent la possibilité d’une reproduction indépendante, et cette limite doit être explicite.
Pour une équipe, la conclusion pratique consiste à utiliser le test comme outil de diagnostic, et non comme autorisation automatique de déploiement. Si le système répond avec des citations, il importe de vérifier si elles étayent les affirmations. Si le risque principal concerne des documents obsolètes ou contradictoires, il faut tester ces situations avec ses propres documents et des règles de résolution adaptées. Et si une abstention sûre est requise, le comportement acceptable pour le domaine concerné doit être défini avant d’observer les réponses.
Liste de vérification avant de publier des résultats
- 01Confirmer l’identifiant exact et décrire toute incertitude concernant la révision ou le canal.
- 02Publier le corpus ou expliquer précisément les restrictions qui empêchent son partage.
- 03Inclure les prompts, la configuration, les questions, le format du contexte et les règles d’annotation.
- 04Présenter chaque mesure séparément, avec son dénominateur, ses limites et des exemples de défaillances.
- 05Déclarer ce qui n’a pas pu être vérifié concernant l’accès, les paramètres, l’exposition antérieure ou la reproductibilité.
Conclusion : un protocole n’est pas un résultat
La question utile n’est pas de savoir si un modèle « cite bien » dans l’absolu, mais ce qu’il fait face à des preuves définies et dans des conditions que d’autres peuvent examiner. Distinguer les preuves suffisantes, les contradictions et leur absence permet de concevoir des contrôles adaptés à chaque situation. Séparer l’exactitude, l’étayage, la qualité des citations et l’abstention empêche un score unique ou une réponse convaincante de masquer des erreurs importantes.
Les sources vérifiées disponibles permettent d’identifier Command R 08-2024 dans la documentation de Cohere et dans un dépôt de Cohere Labs, et de signaler que la documentation Oracle consultée indique que le modèle est obsolète dans ce service. Elles n’établissent pas que le test proposé a été exécuté, ne confirment pas l’accès actuel sur tous les canaux et ne prouvent aucun résultat indépendant concernant les citations, les contradictions ou l’abstention. Cet article présente donc le protocole et ses conditions de validité, sans attribuer de scores au modèle.
Une équipe souhaitant adapter le protocole à sa documentation interne devra constituer son propre jeu de données vérifié, définir ce qu’est une réponse étayée et décider quels niveaux d’incertitude sont acceptables. Ce n’est qu’après avoir vérifié la version et exécuté les conditions consignées qu’il sera pertinent de publier des résultats. Même dans ce cas, les conclusions resteront limitées à la configuration et au corpus étudiés.
Questions ouvertes
- L’accès actuel à l’identifiant exact de Command R 08-2024 n’a pas été vérifié, pas plus que les paramètres qu’il est possible de fixer sur chaque canal.
- La documentation Oracle fournie indique que le modèle est obsolète sur OCI ; cela ne démontre pas son indisponibilité sur d’autres canaux.
- Le protocole n’a pas été exécuté : aucun résultat expérimental ne peut donc être attribué au modèle.
- Les sources fournies ne permettent pas de déterminer si des documents ou des questions d’un jeu de données donné figuraient dans les données d’entraînement.
- La publication du corpus, des questions et des configurations dépendra des droits, de la confidentialité et des conditions d’utilisation, qui doivent être vérifiés au cas par cas.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction