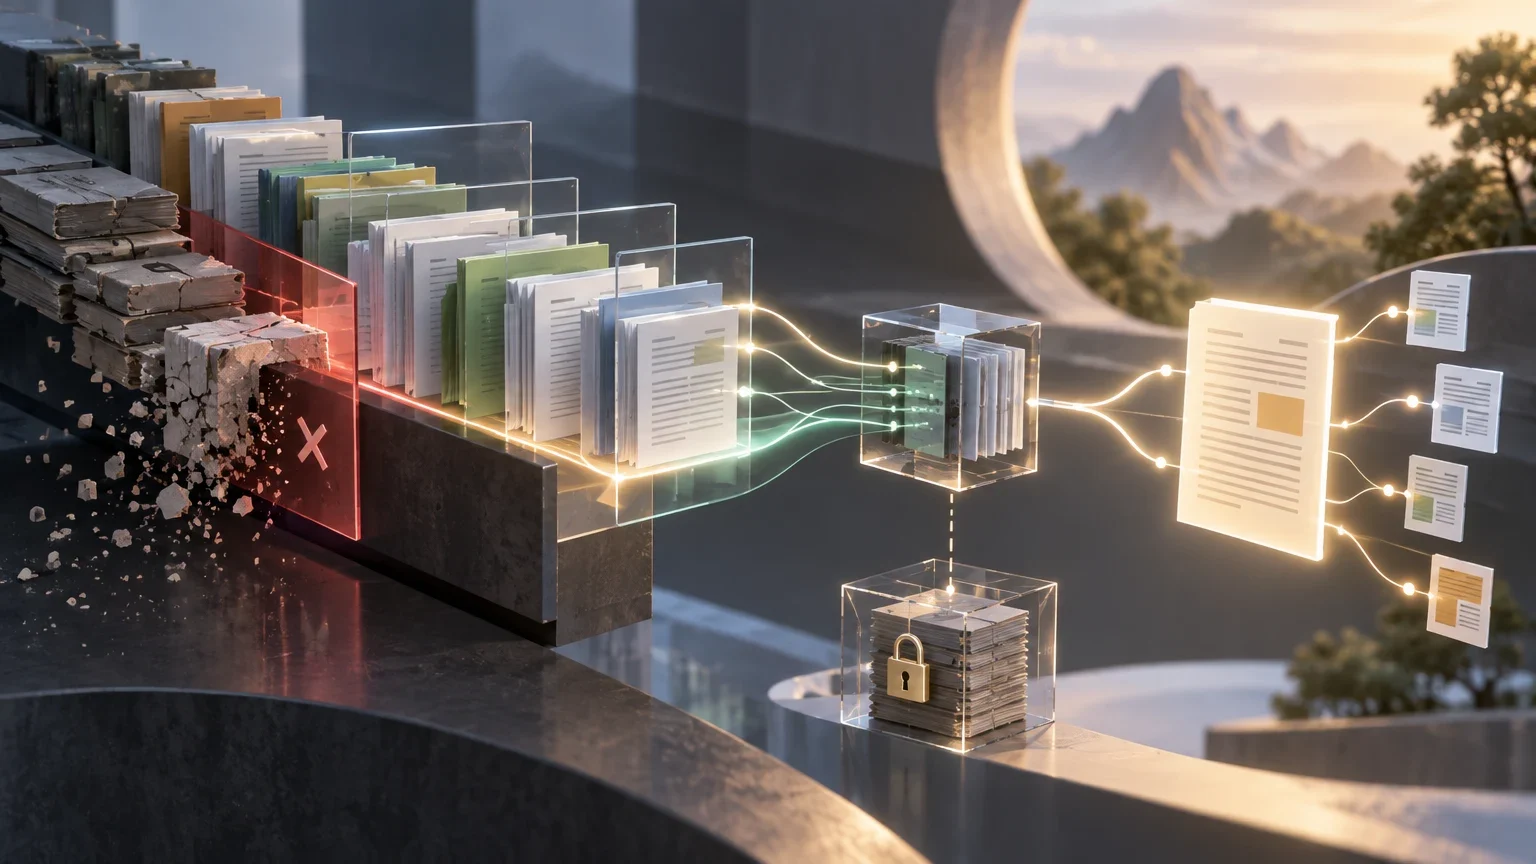
Una guía operativa para mantener el corpus de un sistema RAG cuando las políticas, manuales y documentos cambian. Propone un modelo de datos, flujos de actualización y retirada, controles de acceso y pruebas para reconstruir qué evidencia estaba disponible en el momento de responder.
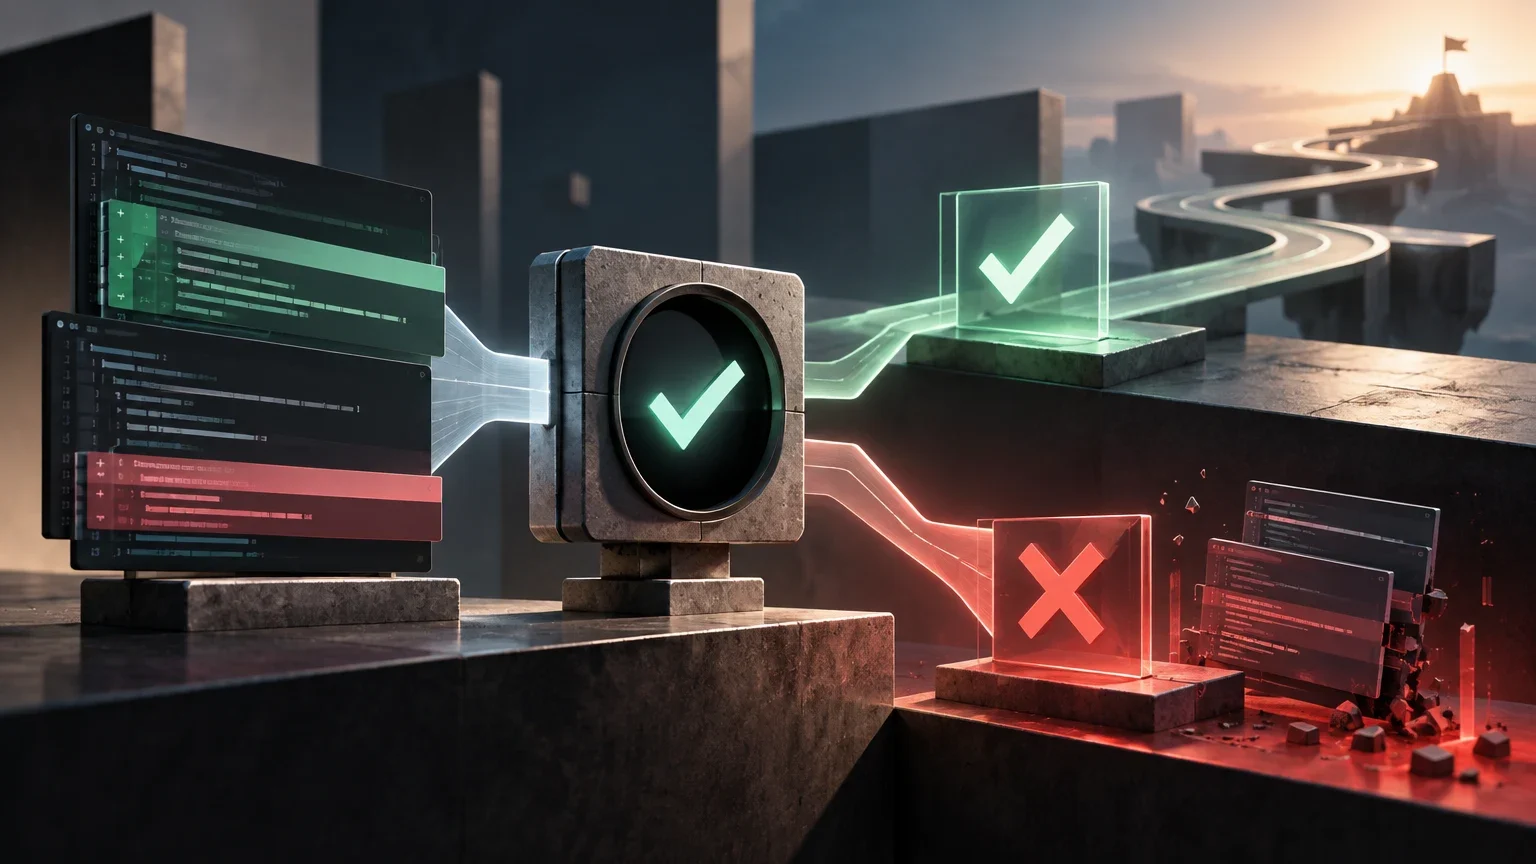
DeepSWE v1.1 evalúa cambios de código producidos por agentes en tareas originales y de largo recorrido. Su resultado puede aportar una señal útil, pero una fila del leaderboard solo es interpretable si se conocen el arnés, la política de errores, los rollouts, el verificador y la versión exacta del benchmark. Una revisión de Epoch AI añade una advertencia concreta: algunos parches que modifican pruebas pueden recibir un falso negativo bajo determinadas condiciones.
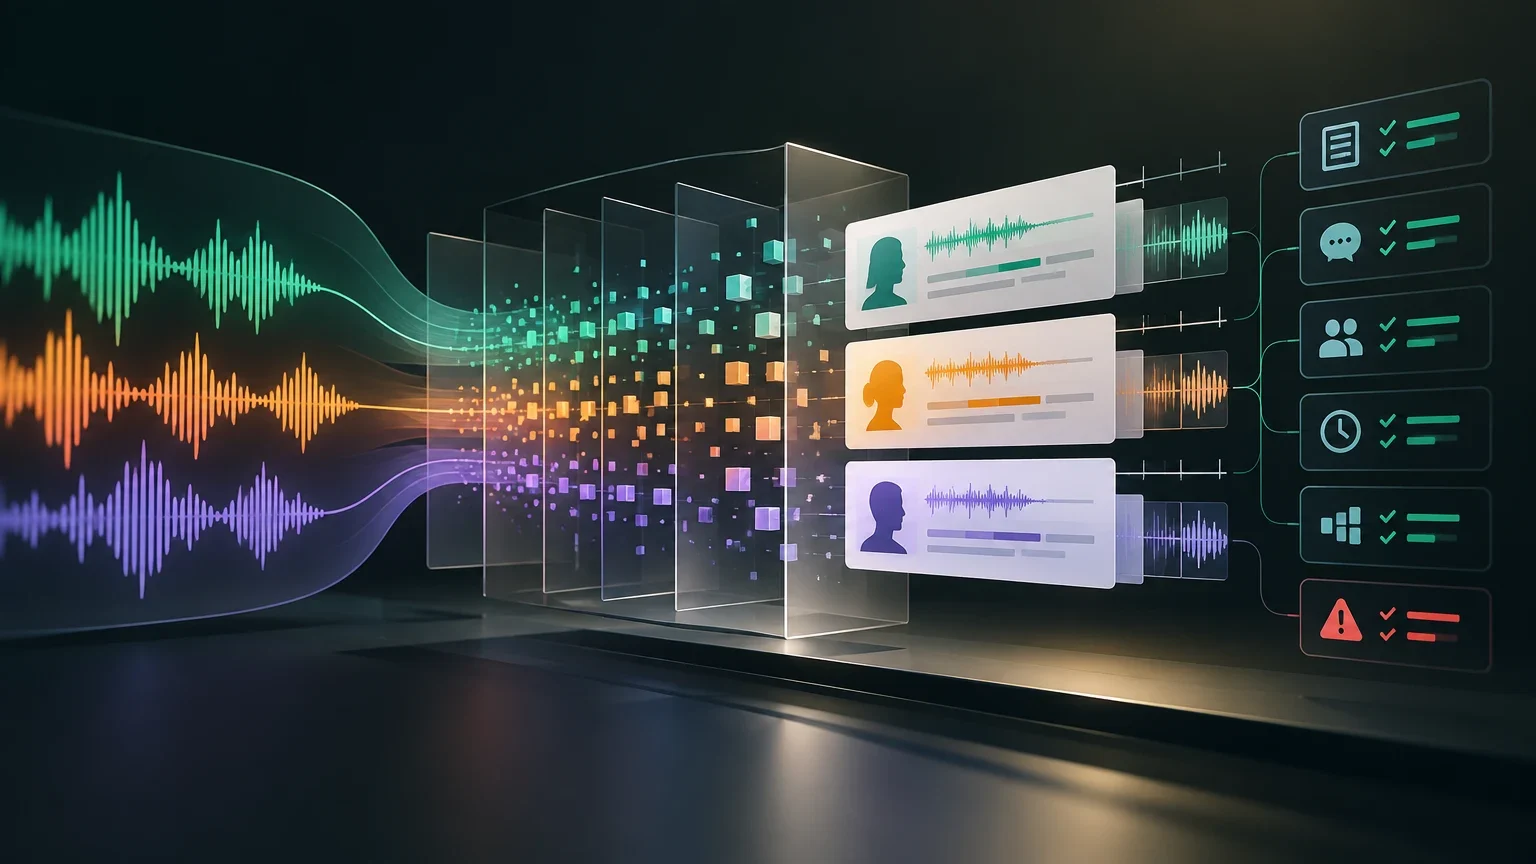
Una evaluación útil de transcripción automática no se resume en un único porcentaje de precisión. Esta guía propone un protocolo para medir, por separado, la fidelidad del texto, las entidades críticas, la atribución de hablantes, las marcas de tiempo, la segmentación y la validez de la salida que consume una aplicación. El objetivo es comparar versiones y configuraciones de forma reproducible, y decidir con evidencia cuándo promover, restringir o bloquear un despliegue.
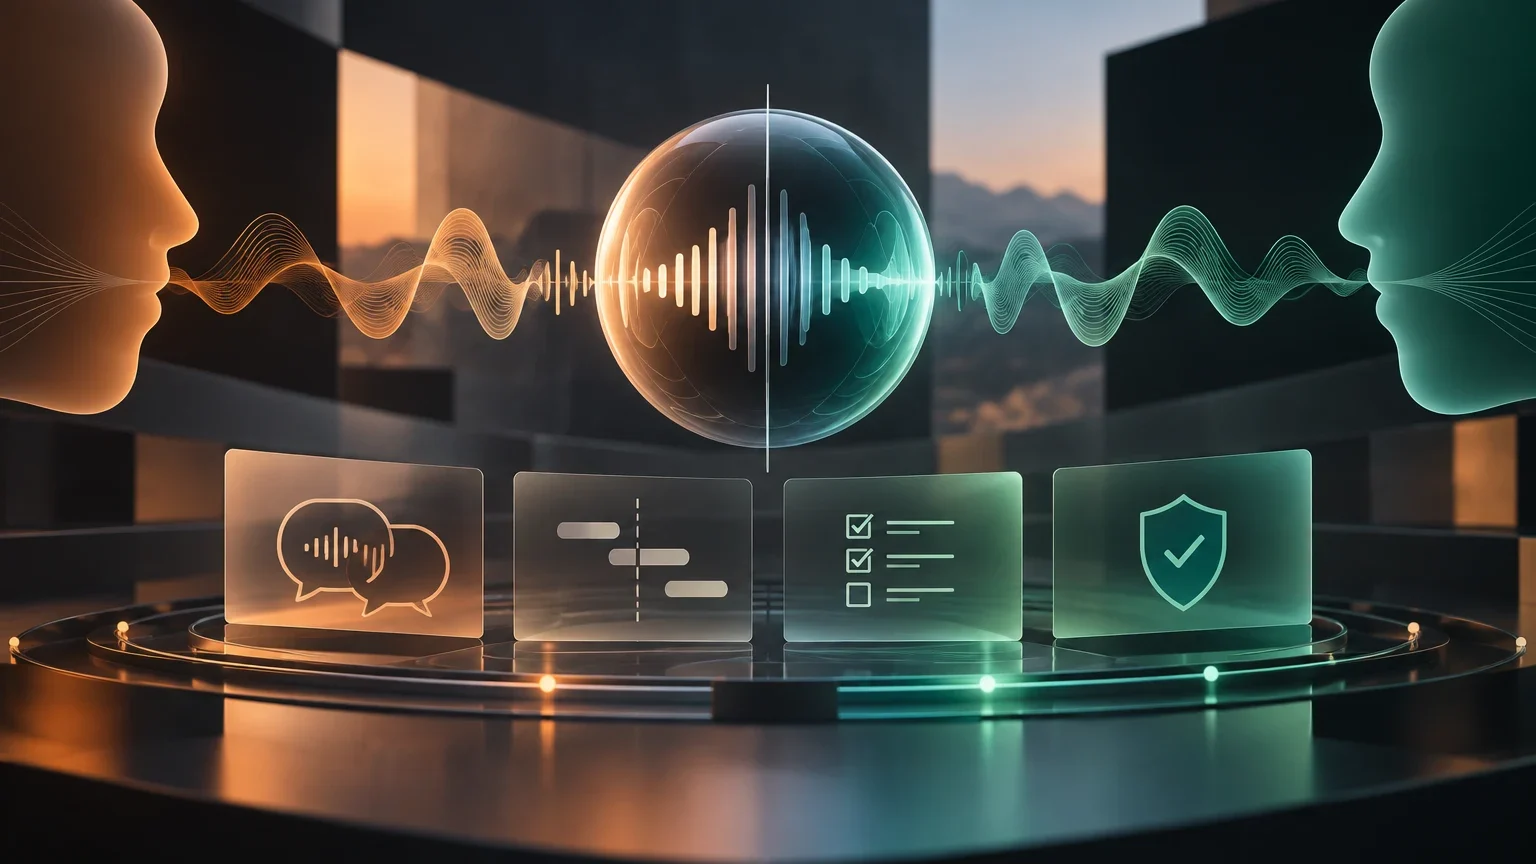
Guía para evaluar GPT‑Live‑1 en conversaciones de voz full‑duplex separando dinámica de turnos, comprensión, éxito de tarea y seguridad de acciones delegadas. Propone un protocolo reproducible con audio controlado, trazas, anotación temporal y revisión humana ciega.
Adoptar Gemini no describe por sí solo una arquitectura ni un compromiso operativo. Un mismo equipo puede usar un modelo de Google mediante Gemini API, AI Studio, Vertex AI o un producto gestionado, con identificadores, controles de datos, herramientas y ciclos de vida que deben verificarse por separado.
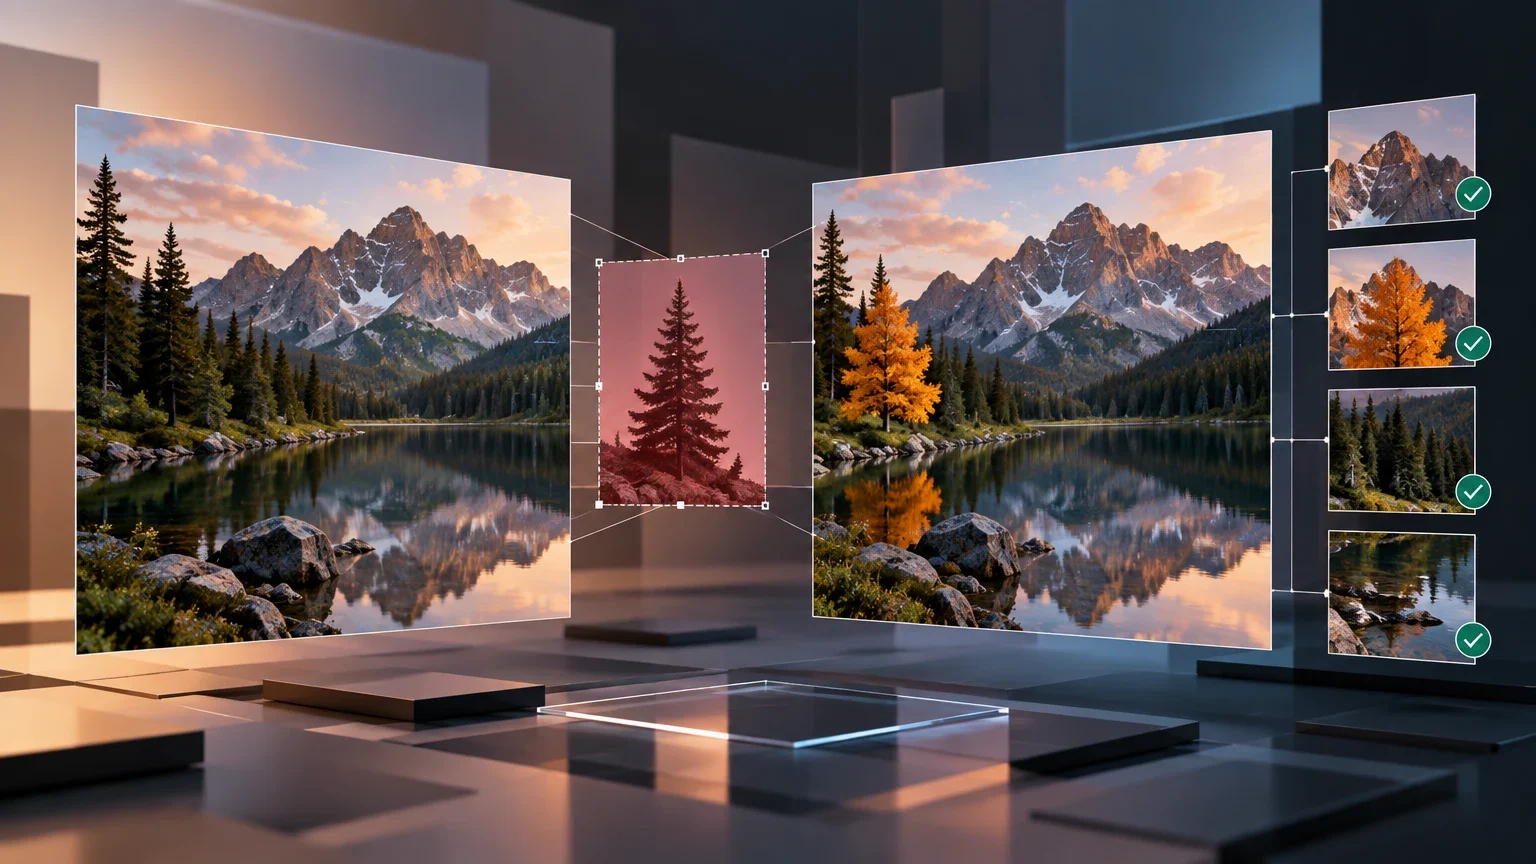
Una edición generativa útil en producción no se valida solo porque el cambio solicitado parezca correcto. Esta guía propone tratar cada retoque como un contrato de preservación: definir qué puede cambiar, qué debe mantenerse, cómo medirlo y cuándo exigir revisión humana.
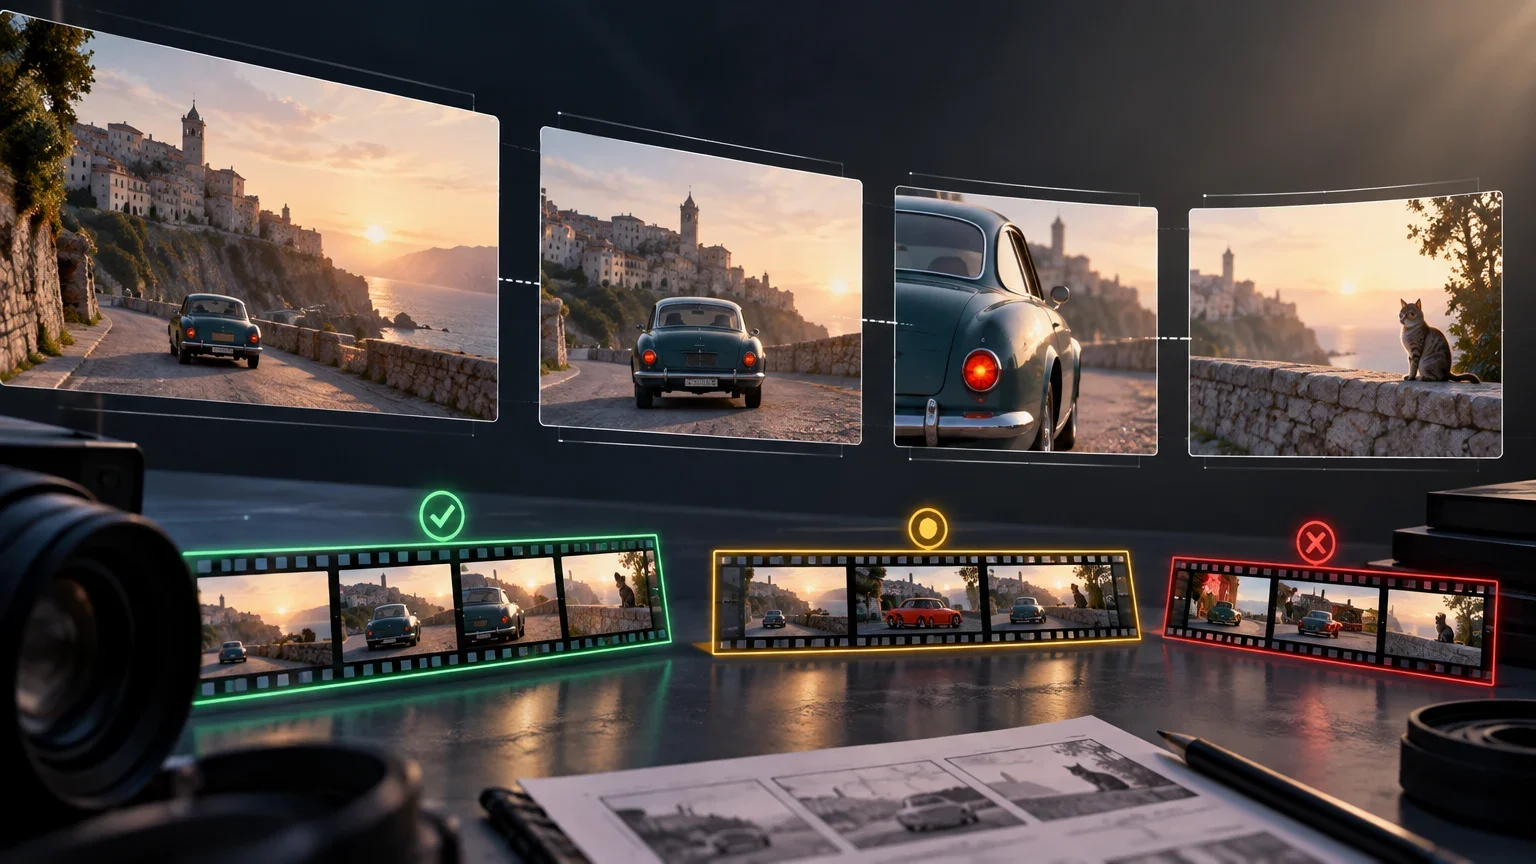
Un plano generado puede resultar convincente por sí solo y, aun así, ser inutilizable al montarlo con otros. Esta guía propone un protocolo para evaluar continuidad visual, espacial y narrativa en secuencias de vídeo generativo, registrar su trazabilidad y decidir qué clips se aprueban, cuáles requieren intervención y cuáles deben descartarse.
Claude Fable 5.1 debe evaluarse como un contrato de ejecución y no como una etiqueta de capacidad. Esta ficha separa lo que declaran Google Cloud y Amazon Bedrock de lo que depende del canal y de lo que un equipo debe medir antes de conceder autonomía a un flujo de producción.
Claude Haiku 4.5 puede ser un destino para cargas rápidas tras la retirada de Claude Haiku 3.5, pero una migración segura no se resuelve cambiando un identificador. La disponibilidad mínima documentada hasta el 15 de octubre de 2026 no garantiza permanencia indefinida. El criterio operativo es demostrar, con tráfico y corpus propios, latencia de cola, cumplimiento de esquema, uso de herramientas y una sustitución reversible.
Una mejora observada con Claude Opus 4.5 puede proceder del modelo, pero también de cambios en el contexto, las herramientas, los reintentos o el verificador. Este protocolo ayuda a separar esas causas antes de ampliar un despliegue.
Mistral AI documenta Voxtral TTS como un servicio de generación de voz con streaming y varios formatos de salida. Antes de reemplazar un proveedor o modelo en llamadas, avisos o contenido publicado, un equipo debe comprobar no solo la calidad audible, sino también la compatibilidad del contrato técnico, operativo y de datos mediante una regresión con sus propios guiones.
GPT-Transcribe figura como un modelo de transcripción disponible a través de la API de OpenAI. Antes de reemplazar un sistema ASR existente, conviene validar no solo el texto resultante, sino también el contrato técnico que sostiene buscadores, resúmenes, alertas, citas, revisiones y registros de cumplimiento.