El nuevo modelo combina razonamiento, uso de herramientas y comprensión de texto, imágenes, documentos y vídeo. NVIDIA declara 12.000 millones de parámetros activos por token y mejoras de eficiencia, pero los resultados publicados no bastan para establecer una comparación independiente ni un coste universal de inferencia.
Análisis metodológico de la métrica 'Bound' en la suite de evaluación de AesCode de Microsoft. Se examina su función como restricción programática en la generación de infografías, su integración con otras métricas y los límites para la comparabilidad entre modelos.
Una cita no demuestra que una afirmación sea correcta. Aprende a separar las afirmaciones comprobables, leer la evidencia en contexto y registrar una decisión que otra persona pueda repetir.
Guía de diseño para definir registros de memoria, políticas de ciclo de vida y pruebas de verificación en agentes de IA, distinguiendo entre memoria persistente, historial y estado temporal.
Análisis de la disponibilidad de documentación primaria para verificar las licencias de código, pesos y datos de los modelos de Ai2, destacando las lagunas actuales en la trazabilidad legal.
Una acción emitida, una herramienta que responde y una tarea completada son cosas distintas. Aprende a definir un resultado observable, elegir evidencia adecuada y comunicar con precisión qué se ha verificado.
Un protocolo práctico para delimitar una tarea, compararla con el proceso actual y una alternativa determinista, y fijar antes de probar los criterios de aceptación, revisión humana y parada.
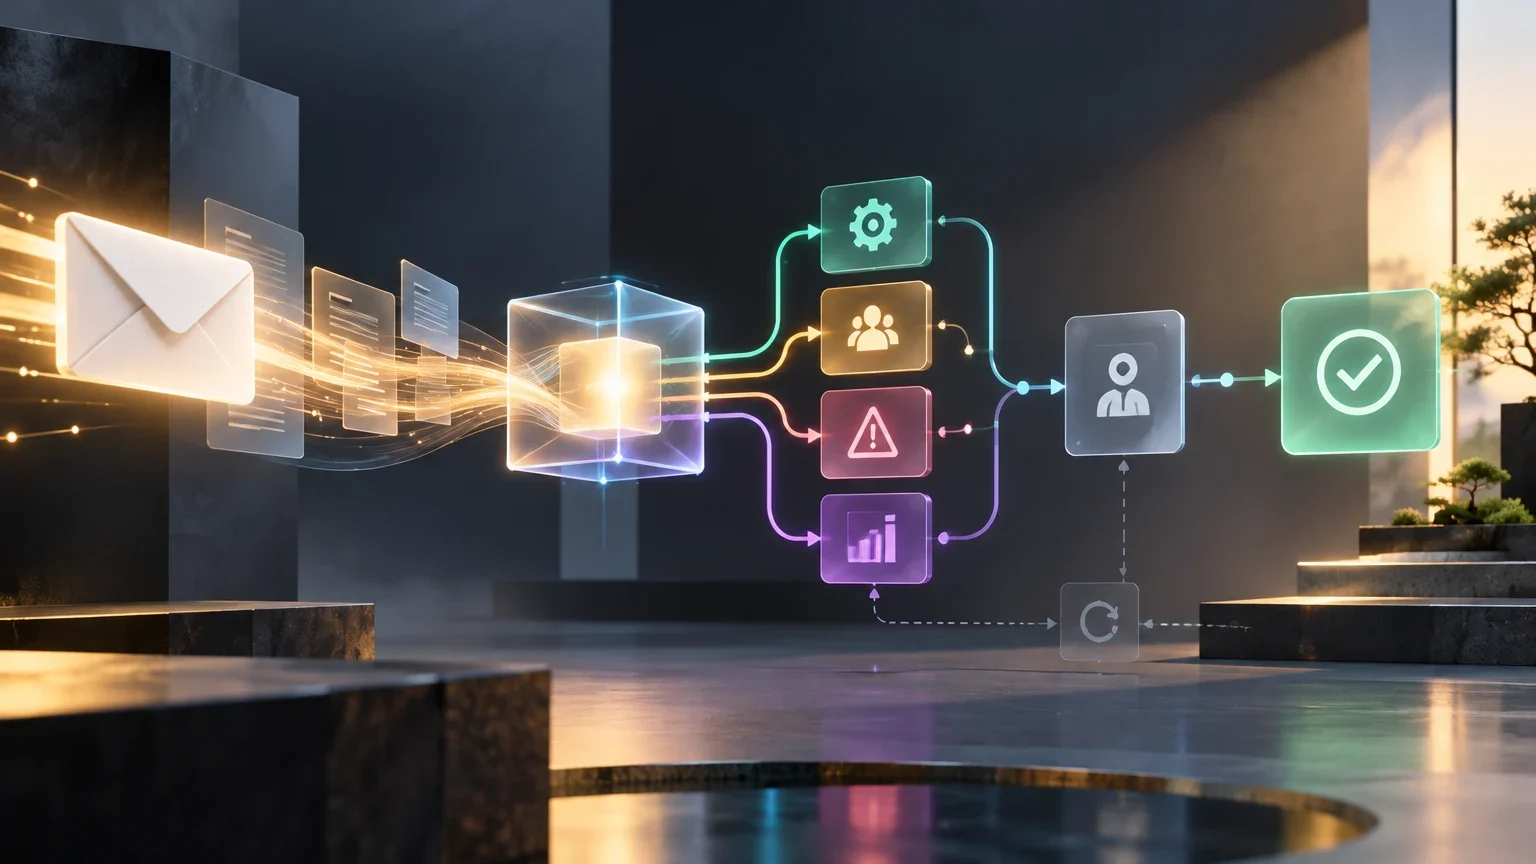
Guía práctica para especificar, probar e integrar un flujo que recibe solicitudes, propone una categoría y deriva los casos con límites claros, revisión humana y recuperación ante fallos.
Análisis técnico de la viabilidad operativa de ejecutar y comparar Bolmo 1B Stage 1 y Bolmo 7B Stage 1 en entornos locales. Se define un marco de decisión basado en requisitos de hardware, aislamiento de datos y coste de inferencia, diferenciando entre especificaciones confirmadas y métricas que requieren validación empírica.
El preentrenamiento es la fase en la que un modelo aprende representaciones generales antes de ser especializado. Esta guía explica su definición, proceso, ejemplos en lenguaje, visión y biomédico, y sus límites prácticos.
Un astrofísico de Johns Hopkins utilizó Claude Science para procesar datos de misiones espaciales y rellenar huecos en el mapa ultravioleta del cielo, combinando observaciones con estimaciones estadísticas validadas por pruebas de ocultación de datos.
Meta ha lanzado Muse Wonder y Muse Wonder Full, sus primeros modelos de frontera, con acceso vía API y suscripción. Analizamos las capacidades anunciadas, los precios y las limitaciones de las comparaciones de rendimiento frente a OpenAI y Anthropic.