Un préprint propose de mesurer les conflits entre agents de code comme un problème de planification. Son résumé déclare des améliorations dans l'intégration propre, mais l'étendue des essais et leur reproductibilité nécessitent d'examiner l'article complet et ses matériaux.
H Company présente deux modèles d'agents capables d'alterner entre interfaces graphiques, exécution de code et outils MCP ou API. Les poids et les résultats sont publiés, bien que les tests ne démontrent ni une autonomie générale ni des performances uniformes dans tous les environnements.
Un guide pour comparer trois façons d’automatiser des tâches en plusieurs étapes selon leur variabilité, le niveau de contrôle, la vérifiabilité et le coût de coordination. Il propose un exemple commun et des questions pour justifier un choix, y compris lorsque la meilleure option consiste à ne pas utiliser d’agent.
L’article 4 du règlement européen sur l’IA impose aux fournisseurs et aux déployeurs de prendre des mesures afin que leur personnel et les autres personnes qui exploitent ou utilisent des systèmes d’IA pour leur compte disposent d’un niveau suffisant de connaissances en matière d’IA. Ce guide explique comment adapter la formation aux fonctions exercées et consigner les mesures prises, sans confondre documentation et certification automatique de conformité.
Un guide pour déterminer qui peut se connecter à un service d’inférence local, quels contrôles vérifier et comment tester l’accès depuis des clients autorisés et non autorisés. Exécuter un modèle sur son propre ordinateur ne l’isole pas automatiquement du réseau.
Google DeepMind et GovTech Singapore ont annoncé un outil qui analyse les risques d’arnaque dans les conversations à l’aide de modèles Gemma exécutés sur l’appareil. Les informations disponibles ne précisent ni la variante utilisée, ni les résultats des tests, ni l’étendue de la protection de la vie privée.
Mistral a présenté Large 4 en préversion publique et annoncé la publication de ses poids pour la fin octobre. L’entreprise revendique un billion de paramètres, dont 52 milliards actifs, mais ces chiffres et les résultats de performance doivent être interprétés avec prudence : la plupart des comparaisons disponibles proviennent d’évaluations présentées par Mistral.
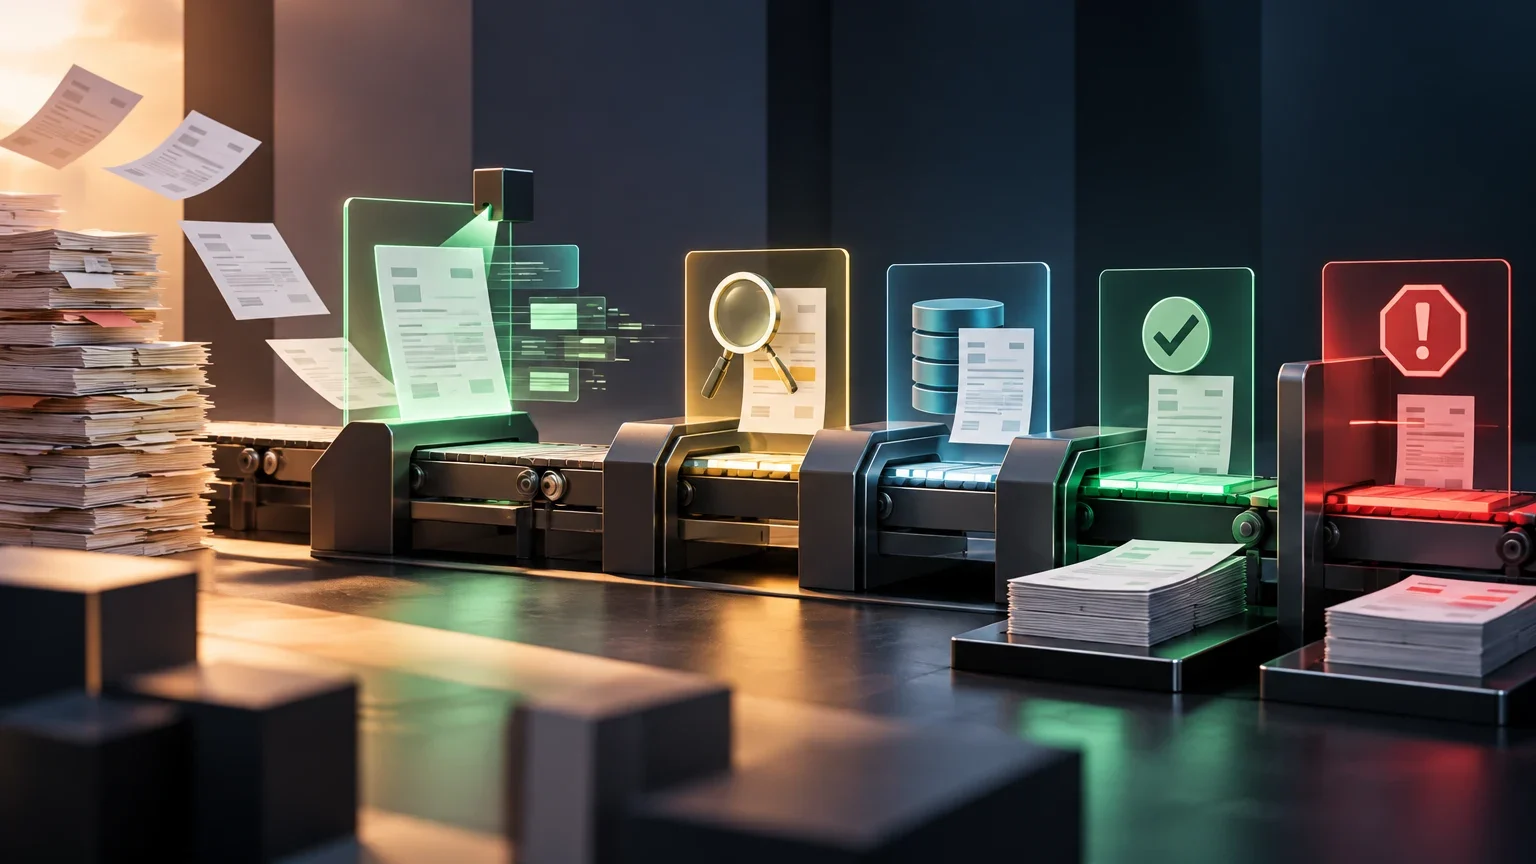
Un guide pour distinguer extraction, validation, enregistrement et approbation. Choisissez les tâches à automatiser en fonction des risques et fixez des limites afin que la lecture d’une facture ne vaille jamais autorisation de paiement.
Google a lancé le 13 octobre le déploiement mondial de Gemini 4 Argon dans l'application Gemini pour les abonnés AI Pro et AI Ultra. La documentation française annonce également un accès élargi dans la Recherche, AI Studio et Antigravity, mais la portée varie selon le produit et l'abonnement : ce n'est pas un lancement pour tous les utilisateurs.
Un modèle avancé a mené une chaîne de réplication jusqu’au bout sur un réseau contrôlé, avec un accès simplifié. Anthropic avertit qu’aucun petit modèle ne combine encore les capacités nécessaires et une taille adaptée à une propagation sur des appareils grand public en conditions réelles.
Agent Lightning relie des agents à leurs outils et à leur gestion du contexte à un flux d’entraînement par renforcement. Le projet propose du code sous licence MIT et présente des résultats qui lui sont propres, lesquels nécessitent encore une évaluation indépendante.
La proposition combine un jumeau numérique du réseau, des algorithmes de graphes et des agents qui choisissent comment analyser chaque incident. Amazon affirme qu'une démonstration avec NTT DOCOMO a identifié des causes racines en quelques minutes, mais les informations disponibles ne détaillent pas de métriques comparatives complètes ni ne confirment un déploiement opérationnel généralisé.