Confronta un flusso manuale assistito, un editor con funzioni di IA e un generatore di bozze usando gli stessi materiali, una rubrica comune e una revisione che misuri fedeltà, controllo e impegno complessivo.
Anthropic afferma che Claude Opus 5.5 ha pareggiato con Fable 5.1 per il tasso più basso di successo degli attacchi di prompt injection tra i modelli valutati da Gray Swan. La documentazione fornita non consente di verificare il dato, il protocollo o le condizioni del confronto. Ecco cosa si può affermare e cosa richiede ancora una verifica.
Anthropic presenta Sonnet 5.5 come un miglioramento rispetto a Sonnet 5, con maggiore velocità e costi inferiori per la maggior parte dei lavori. Esaminiamo che cosa si può affermare sulla base delle fonti disponibili e che cosa ogni team dovrebbe verificare prima di adottarlo.
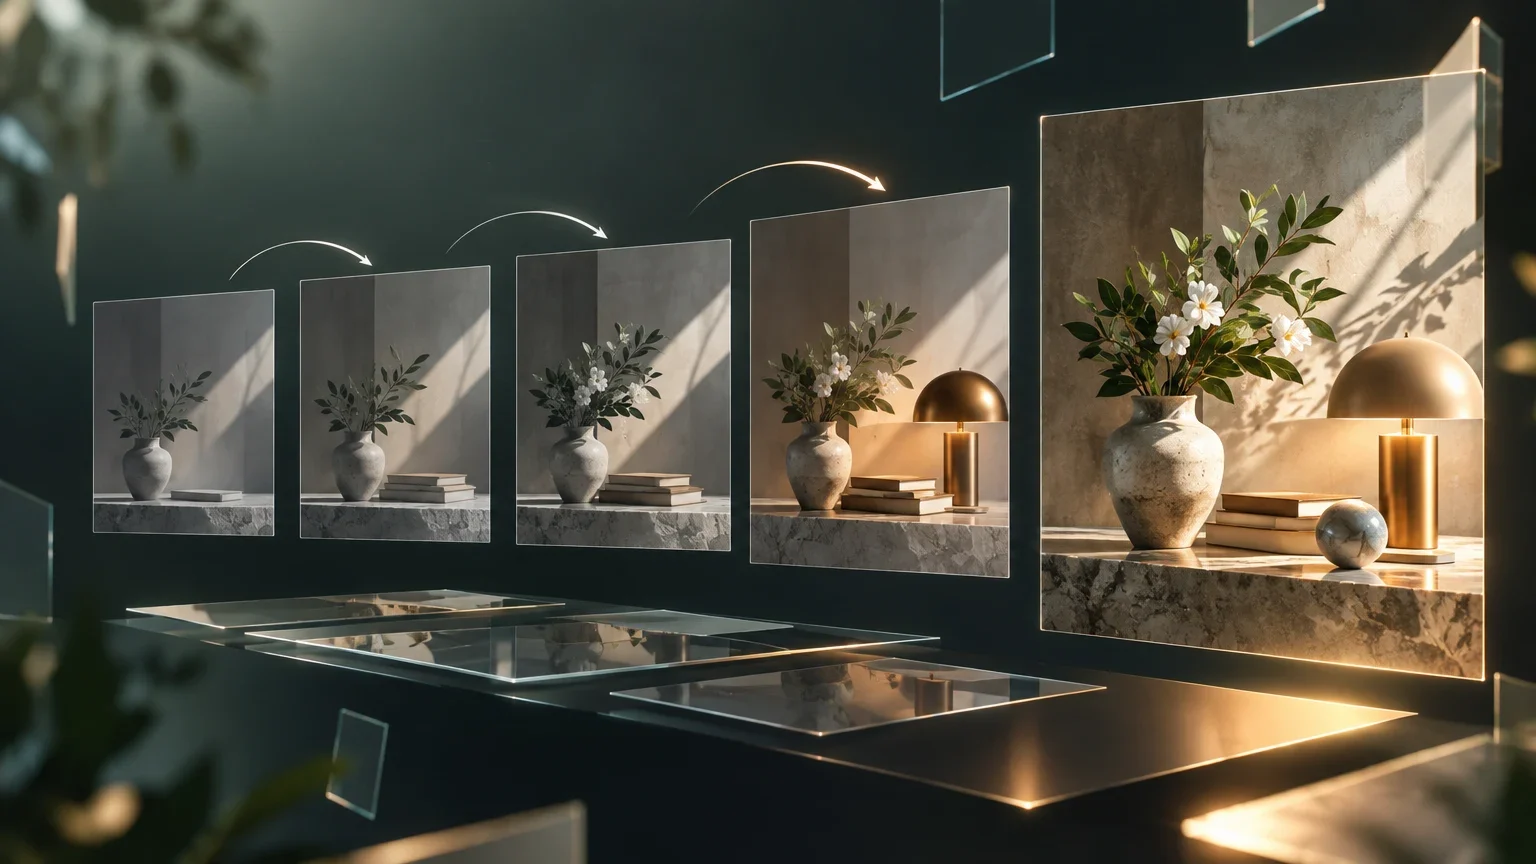
Un protocollo proposto per misurare se Nano Banana 2 applica modifiche successive e conserva gli elementi che le istruzioni non chiedono di cambiare. Non presenta risultati sperimentali: definisce cosa occorrerebbe eseguire e documentare per ottenerli.
Non basta confrontare una tariffa per chiamata o per unità di utilizzo. Per capire se Embed 4 conviene su un corpus specifico, occorre prima verificare le condizioni commerciali del canale e misurare la qualità con query e criteri di rilevanza definiti in anticipo.
Una guida pratica per trasformare l’alfabetizzazione all’IA in competenze legate a compiti e rischi concreti. Distingue ciò che indicano le fonti istituzionali dalle misure operative consigliate.
L’azienda ha aperto negli Stati Uniti liste d’attesa per un agente integrato in Apple Messages e per un’API dedicata agli ordini all’ingrosso. Restano da chiarire aspetti fondamentali, come la conferma del pagamento, i ristoranti disponibili e il trattamento delle conversazioni.
CheatBench viene presentato da notizie secondarie come un benchmark per studiare comportamenti di reward hacking. Le informazioni disponibili consentono di spiegare la domanda a cui intende rispondere, ma non di confermare i dettagli sperimentali né di estenderne i risultati ai sistemi in produzione.
Una fonte riferisce un annuncio per l’India, ma la documentazione disponibile non consente di confermare quali modelli, date o configurazioni siano disponibili nel Paese, né di verificare un’espansione equivalente in Corea del Sud e a Singapore.
Una guida per decidere quale attività di supporto testare, quale livello di delega accettare e quali dati, controlli umani e verifiche richiedere prima di ampliare l’uso.
L’evoluzione dell’interazione con l’IA si può leggere come un cambiamento in ciò che una persona chiede al sistema e in ciò che il sistema può fare. Le fonti disponibili documentano però esempi di interfacce e assistenza, non una transizione storica uniforme né una capacità generale di eseguire azioni.
Un metodo per sperimentare lo screening di titoli e abstract secondo i criteri della propria revisione, confrontare errori e carico di lavoro e decidere quali attività mantenere sotto controllo umano.