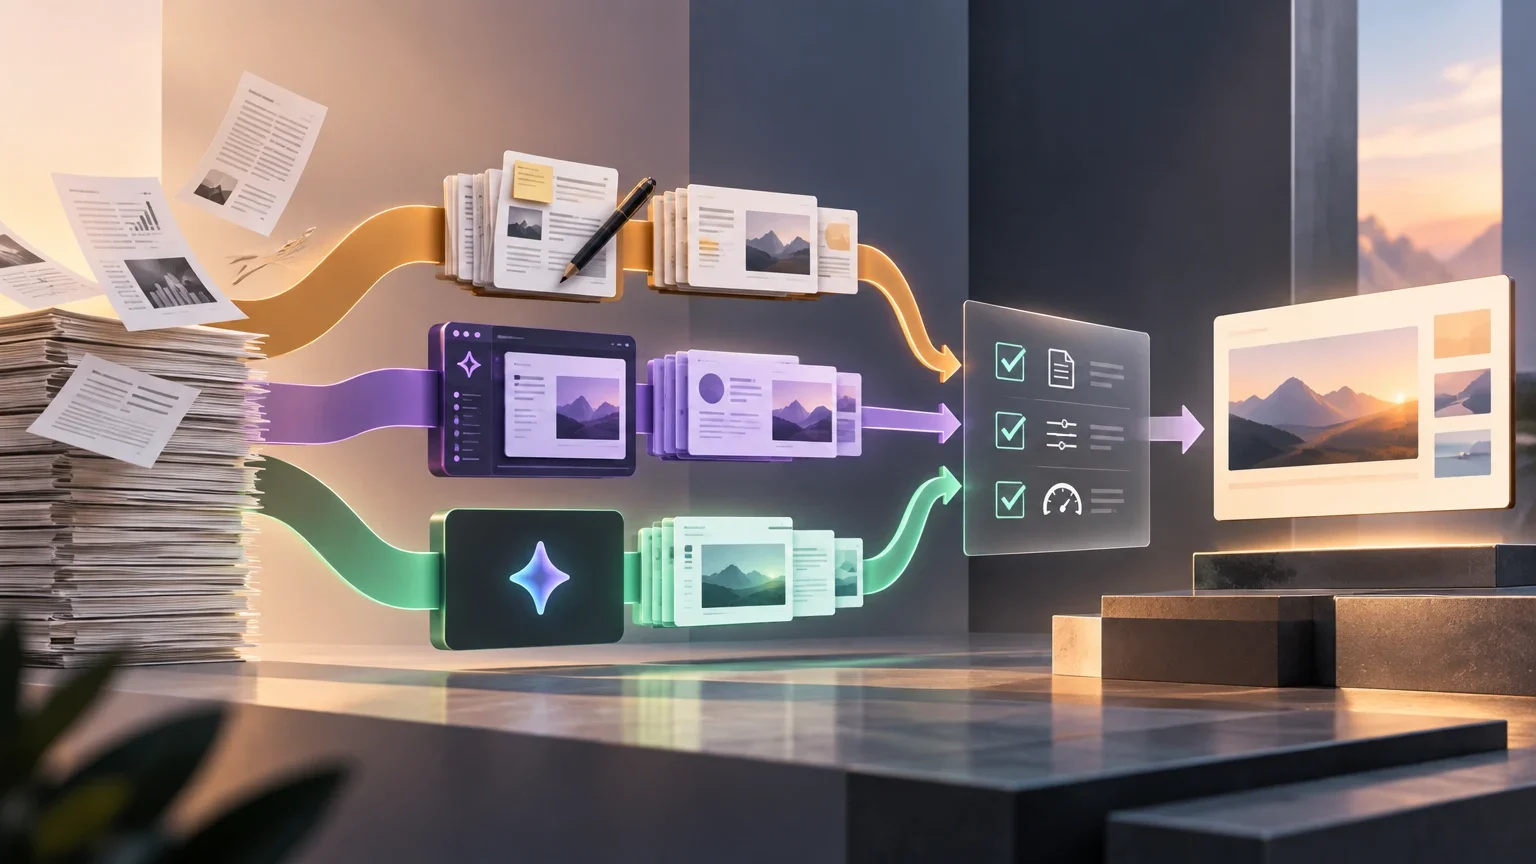
Comparez un flux manuel assisté, un éditeur doté de fonctions d’IA et un générateur de brouillons à partir des mêmes documents, d’une grille commune et d’une vérification portant sur la fidélité, le contrôle et l’effort total.
Anthropic affirme que Claude Opus 5.5 est à égalité avec Fable 5.1 pour le taux de réussite le plus faible face aux injections de prompts parmi les modèles évalués par Gray Swan. La documentation fournie ne permet pas de vérifier le chiffre, le protocole ni les conditions de cette comparaison. Voici ce que l’on peut affirmer et ce qui doit encore être vérifié.
Anthropic présente Sonnet 5.5 comme une amélioration par rapport à Sonnet 5, avec davantage de vitesse et un coût inférieur pour la plupart des tâches. Nous examinons ce que les sources disponibles permettent d’affirmer et ce que chaque équipe devrait vérifier avant de l’adopter.
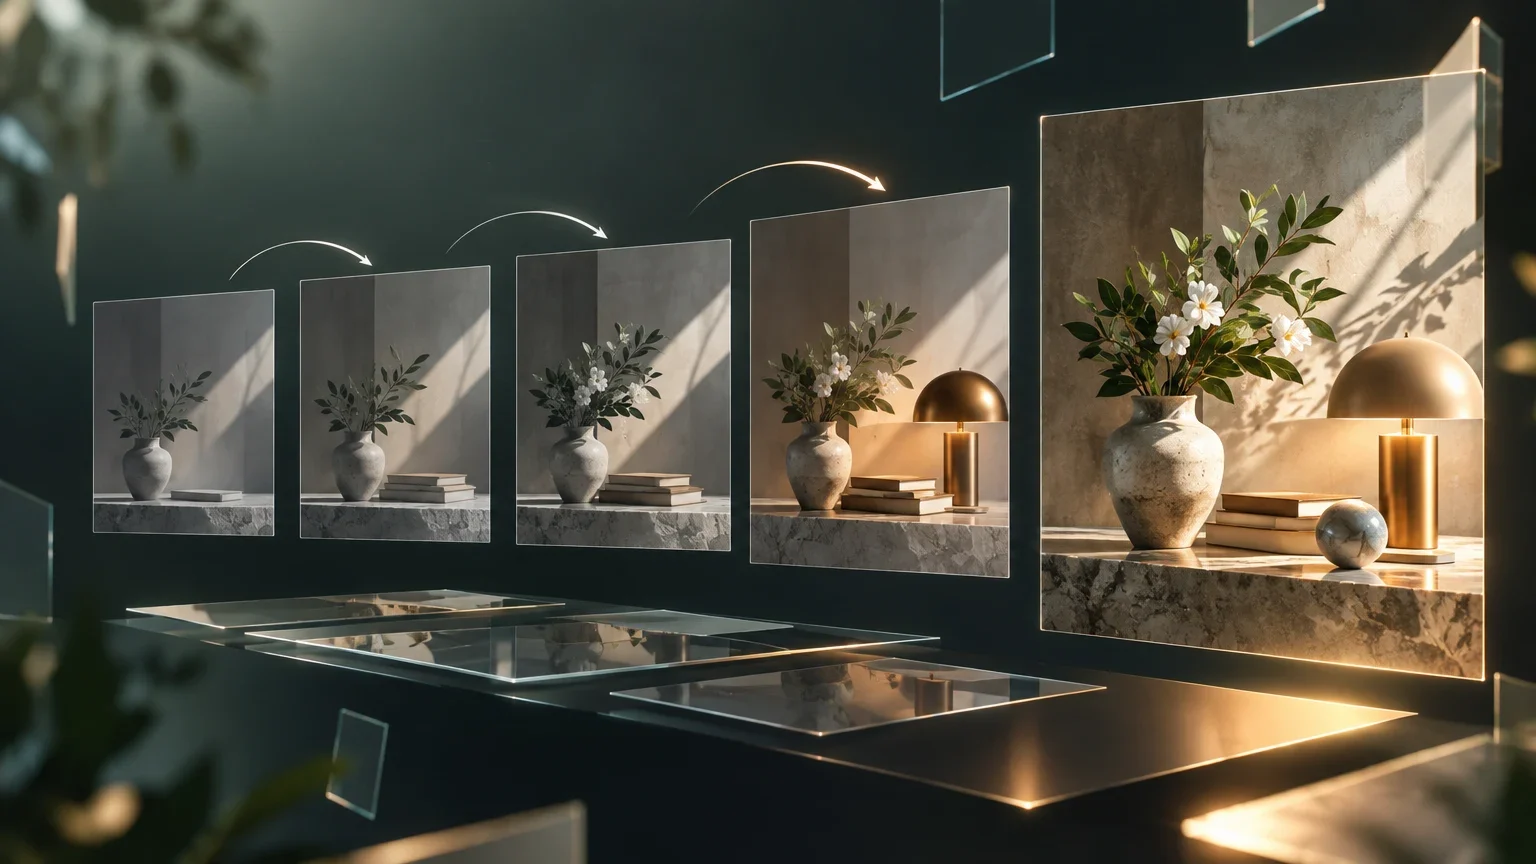
Un protocole proposé pour mesurer si Nano Banana 2 applique des modifications successives tout en préservant les éléments que les consignes ne demandent pas de changer. Il ne présente pas de résultats expérimentaux : il définit les tests et les informations à consigner pour les obtenir.
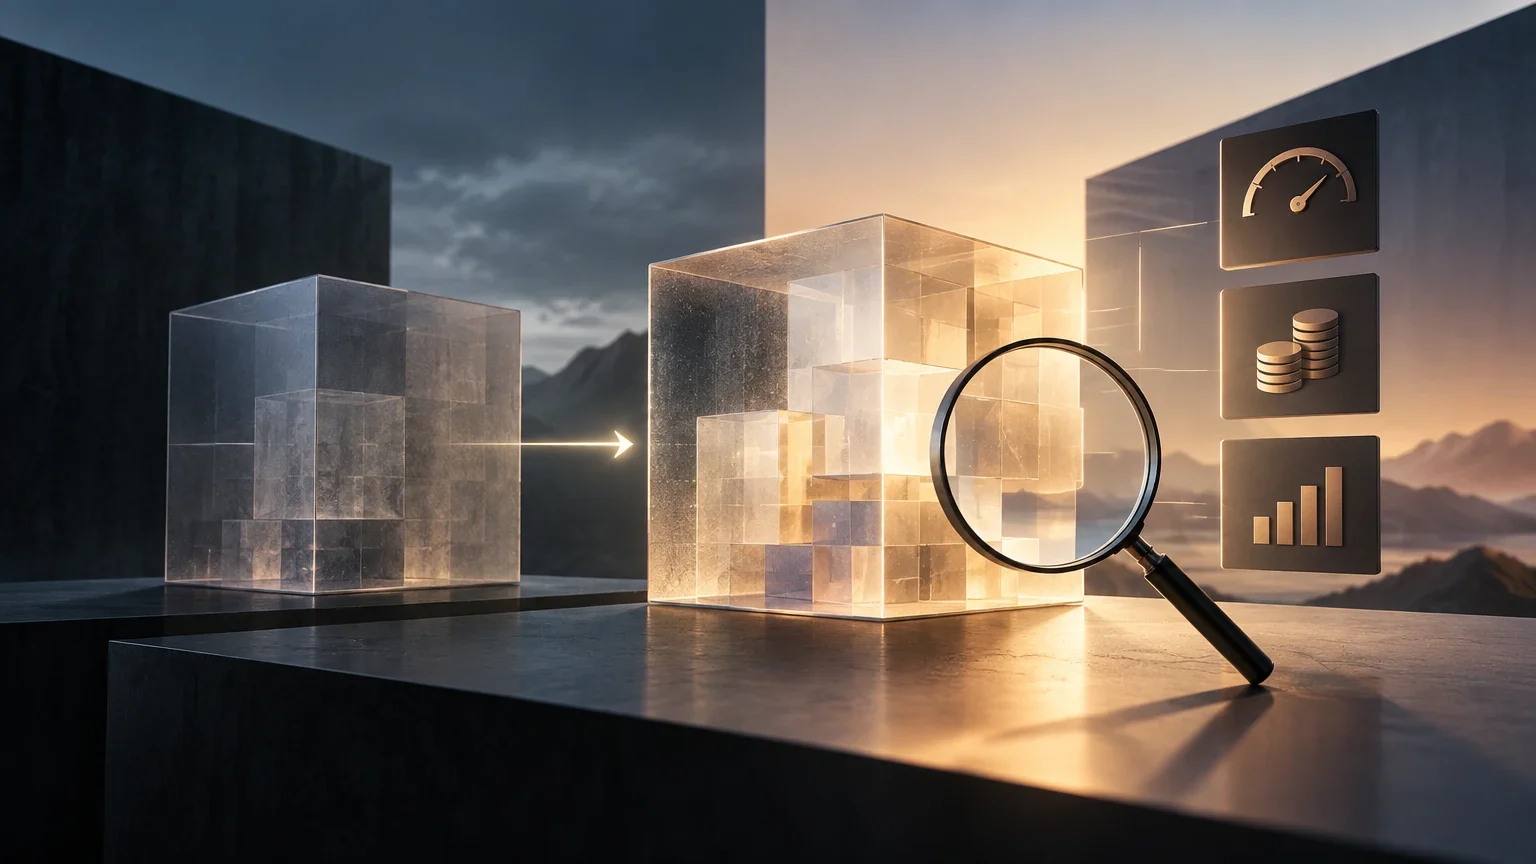
Comparer un tarif par appel ou par unité de facturation ne suffit pas. Pour savoir si Embed 4 est intéressant sur un corpus donné, il faut d’abord vérifier les conditions commerciales du canal utilisé, puis mesurer la qualité à partir de requêtes et de critères de pertinence définis à l’avance.
Un guide pratique pour développer des compétences en IA adaptées aux tâches et aux risques concrets. Il distingue les indications des sources institutionnelles des mesures opérationnelles recommandées.
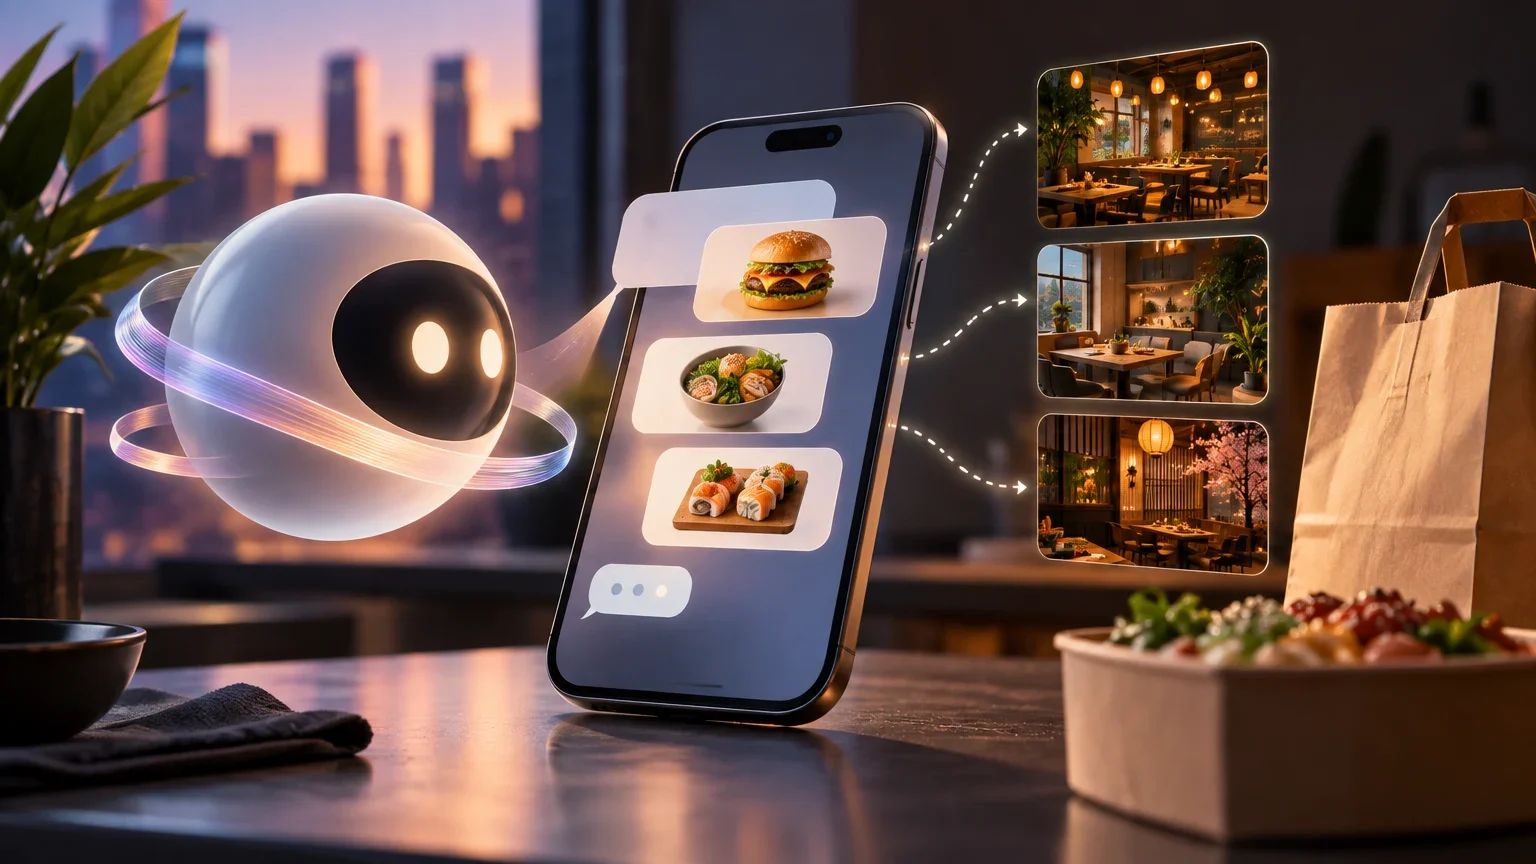
L’entreprise a ouvert aux États-Unis des listes d’attente pour un agent intégré à Apple Messages et pour une API dédiée aux commandes en gros. Plusieurs points essentiels restent à préciser, notamment la validation du paiement, les restaurants disponibles et le traitement des conversations.
CheatBench est présenté dans des articles secondaires comme un benchmark destiné à étudier les comportements de reward hacking. Les informations disponibles permettent d’expliquer la question posée, mais pas de confirmer les détails expérimentaux ni de généraliser les résultats à des systèmes en production.
Une source fait état d’une annonce pour l’Inde, mais la documentation fournie ne permet de confirmer ni les modèles, ni les dates, ni les configurations disponibles sur place, et ne vérifie pas d’expansion équivalente en Corée du Sud ou à Singapour.
Un guide pour décider quelle tâche de support tester, quel niveau de délégation accepter et quelles données, quels contrôles humains et quels essais exiger avant d’élargir l’usage.
L’évolution des interactions avec l’IA peut se lire à travers ce qu’une personne demande au système et ce que celui-ci peut accomplir. Mais les sources disponibles documentent des exemples d’interfaces et d’assistance, pas une transition historique uniforme ni une capacité générale à exécuter des actions.
Une méthode pour tester le criblage des titres et résumés selon les critères de votre revue, comparer les erreurs et la charge de travail, puis déterminer quelles tâches doivent rester sous contrôle humain.