Compara un flujo manual asistido, un editor con funciones de IA y un generador de borradores con el mismo material, una rúbrica común y una revisión que mida fidelidad, control y esfuerzo total.
Anthropic afirma que Claude Opus 5.5 empató con Fable 5.1 en la tasa más baja de éxito de inyección entre los modelos evaluados por Gray Swan. La documentación suministrada no permite comprobar la cifra, el protocolo ni las condiciones de esa comparación. Esto es lo que puede afirmarse y lo que aún necesita verificación.
Anthropic presenta Sonnet 5.5 como una mejora frente a Sonnet 5, con más velocidad y menor coste para la mayoría de los trabajos. Revisamos qué puede afirmarse con las fuentes disponibles y qué debe comprobar cada equipo antes de adoptarlo.
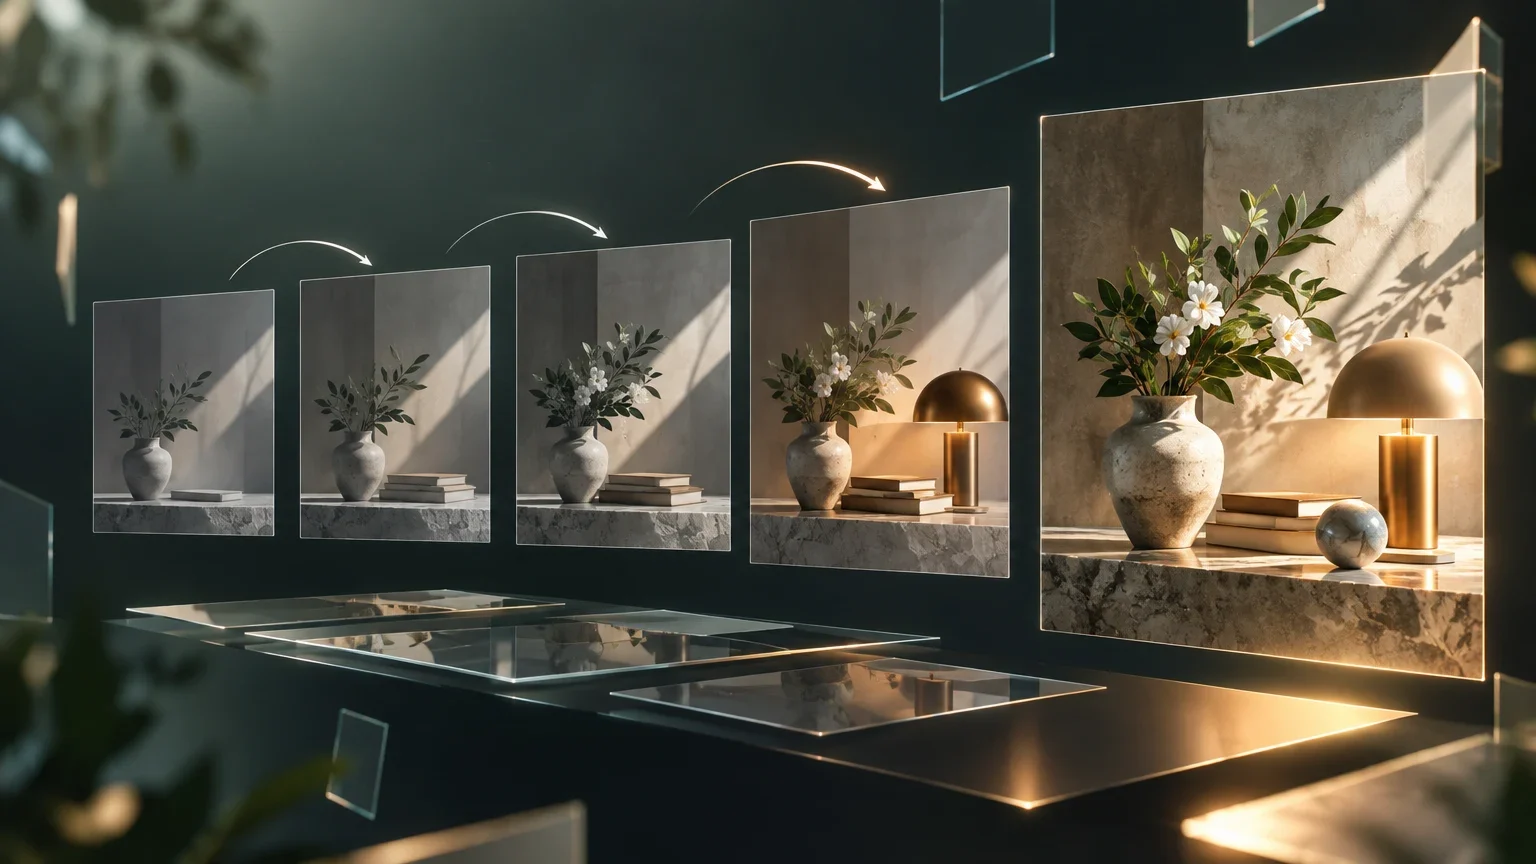
Un protocolo propuesto para medir si Nano Banana 2 aplica cambios sucesivos y conserva los elementos que las instrucciones no piden modificar. No presenta resultados experimentales: define qué habría que ejecutar y documentar para obtenerlos.
No basta con comparar una tarifa por llamada o por unidad de uso. Para saber si Embed 4 compensa en un corpus concreto, hay que verificar primero las condiciones comerciales del canal y medir la calidad con consultas y criterios de relevancia definidos de antemano.
Una guía práctica para convertir la alfabetización en IA en capacidades ligadas a tareas y riesgos concretos. Separa lo que indican las fuentes institucionales de las medidas operativas recomendables.
La compañía ha abierto en Estados Unidos listas de espera para un agente integrado en Apple Messages y para una API de pedidos al por mayor. Todavía no se han aclarado aspectos clave, como la confirmación del pago, los restaurantes disponibles o el tratamiento de las conversaciones.
CheatBench se presenta en noticias secundarias como un benchmark para estudiar conductas de reward hacking. La información disponible permite explicar la pregunta que plantea, pero no confirmar los detalles experimentales ni extrapolar sus resultados a sistemas en producción.
Una fuente informa de un anuncio para India, pero la documentación aportada no permite confirmar qué modelos, fechas o configuraciones están disponibles allí ni verificar una expansión equivalente a Corea del Sur y Singapur.
Una guía para decidir qué tarea de soporte probar, qué nivel de delegación aceptar y qué datos, controles humanos y pruebas exigir antes de ampliar el uso.
La evolución de la interacción con la IA puede leerse como un cambio en lo que una persona le pide al sistema y en lo que este puede hacer. Pero las fuentes disponibles documentan ejemplos de interfaces y asistencia, no una transición histórica uniforme ni una capacidad general para ejecutar acciones.
Un método para probar el cribado de títulos y resúmenes con los criterios de tu revisión, comparar errores y carga de trabajo, y decidir qué tareas deben seguir bajo control humano.